Qual è il numero che decide quale modello multi-tenant scegliere?
Fino a 4 clienti conviene un'istanza per cliente; da 5 a 16 un database o uno schema per cliente; da 17 in su un database condiviso. Con 40 clienti, il condiviso costava circa 25.800 euro in tre anni, contro 104.040 euro di un'istanza per ciascuno.
Una software house veronese ha un gestionale per studi professionali, scritto in .NET, che funziona bene da sei anni. Ogni cliente ha la sua installazione: una macchina virtuale, un database, un'applicazione, un pacchetto di aggiornamento che qualcuno deve portare sul posto o lanciare da remoto. Quando i clienti erano cinque andava benissimo. Oggi sono ventidue, e a gennaio ne firmano altri otto.
Il titolare vuole trasformarlo in un servizio in abbonamento, un SaaS, ma ha davanti due preventivi che non riesce a confrontare. Uno propone "un'istanza per ogni cliente, ma automatizzata". L'altro propone di riscrivere tutto "multi-tenant", e cita parole che nessuno nella stanza sa spiegare.
Questo articolo ti dice che cos'è un'architettura multi-tenant, quali modelli esistono per tenere separati i dati dei clienti, quanto costa ciascuno in tre anni con i numeri di un'azienda tipo, come si costruisce in ASP.NET Core ed Entity Framework Core quello che nella maggior parte dei casi conviene, e come si impedisce che un cliente veda i dati di un altro.
Troverai il conto dei cinque modelli in euro, il numero che decide quale scegliere, il codice C# e SQL che compila, il test che ti protegge dall'errore peggiore, l'elenco delle cose che si dimenticano quasi sempre (lavori in background, cache, file, posta, ricerche) e un piano di quarantacinque giorni per passare da un'installazione per cliente a un servizio vero.
Una premessa. Ho costruito e venduto LegalDesk, un SaaS legale multi-tenant, e da ventisei anni progetto software per aziende. Non ti devo vendere una riscrittura: ti dico quando conviene, quando non conviene, e quale è la strada più piccola che regge. Il caso che uso è un'azienda tipo, costruita con ordini di grandezza e medie di settore. Non è un cliente, è un metodo: lo rifai con i tuoi numeri in un pomeriggio.
Che cos'è un'architettura multi-tenant e perché la scelta si paga per anni?
Un'architettura multi-tenant è un modo di costruire un programma in modo che una sola applicazione serva più clienti, chiamati in gergo tenant, tenendo i dati di ciascuno separati dagli altri. Il cliente non sa di condividere qualcosa. Vede il suo nome, i suoi dati, la sua configurazione. Dietro, c'è un solo programma da aggiornare, da monitorare e da far girare.
L'alternativa è il modello single-tenant: un'installazione intera per ogni cliente. È ciò che fanno quasi tutte le aziende che nascono come gestionale "da installare" e che poi vogliono vendere in abbonamento.
La scelta non è un dettaglio tecnico che si cambia a metà strada, per tre motivi.
- Tocca ogni tabella e ogni query. Dove sta il dato del cliente, e come si impedisce a un altro di leggerlo, è scritto dappertutto nel codice. Cambiarlo dopo tre anni significa rifare gran parte dell'accesso ai dati.
- Decide il costo di ogni nuovo cliente. Con un'installazione per cliente, il cliente numero cinquanta costa quasi quanto il numero uno. Con un database condiviso, costa pochi euro al mese.
- Decide il tipo di errore che puoi fare. Nel primo caso l'errore tipico è dimenticare di aggiornare una macchina. Nel secondo è far vedere a un cliente i dati di un altro, che è l'errore che finisce sui giornali e nelle lettere dell'avvocato.
Per questo la domanda giusta non è "qual è il modello più moderno", ma "quale errore posso permettermi, e quanto mi costa ogni cliente in più". Il resto dell'articolo risponde a queste due cose.
Un chiarimento che toglie molta confusione. Multi-tenant non vuol dire microservizi, non vuol dire cloud e non vuol dire Kubernetes. Un monolite su un solo server può essere perfettamente multi-tenant, ed è spesso la forma migliore. Se il tuo dubbio è anche quello, ne parlo nella guida su microservizi o monolite.
Com'è fatta l'azienda tipo e da quali numeri parte?
L'azienda tipo è una software house con 12 persone che vende un gestionale verticale a studi professionali. Il prodotto è in ASP.NET Core con SQL Server, vecchio di sei anni, e oggi viene installato cliente per cliente. Decide di venderlo come servizio.
Ecco i numeri che servono, e che rilevi in mezza giornata guardando contratti, fatture del cloud e il registro delle attività del team.
| Misura | Valore | Come si rileva |
|---|---|---|
| Clienti a regime fra tre anni | 40 | Piano commerciale: 10 nel primo anno, 25 nel secondo, 40 nel terzo (media dell'anno) |
| Clienti-anno nel periodo | 75 | 10 più 25 più 40: è la somma che fa pagare l'infrastruttura |
| Rilasci all'anno | 12, uno al mese | Storico degli ultimi dodici mesi |
| Clienti con obbligo contrattuale di separazione fisica | 4 su 40 | Clausole dei contratti: banche, enti pubblici, qualche grande studio |
| Costo di un'ora di programmatore interno | 60 euro | Costo del lavoro diviso per le ore lavorate |
| Costo di una giornata di sviluppo | 480 euro | 8 ore a 60 euro |
| Prezzo dell'abbonamento | 350 euro al mese per cliente | Listino previsto |
Il prezzo dell'abbonamento serve per tenere i piedi per terra. A 350 euro al mese, 40 clienti fanno 14.000 euro al mese di ricavi, 168.000 euro l'anno. Se l'infrastruttura per cliente costasse 60 euro al mese, ti mangerebbe il 17 per cento del ricavo prima di pagare una persona. Se costasse 3 euro, l'1 per cento. È questo, non la moda, il motivo per cui la forma dell'architettura conta.
Due note sui numeri. La prima: i 40 clienti sono un obiettivo, non un dato. Il modello che scegli deve reggere anche se ne arrivano 15, e deve reggere se ne arrivano 120. La seconda: i quattro clienti con obbligo di separazione fisica sono un caso reale e frequente. Chi lavora con banche, assicurazioni ed enti pubblici se lo sente chiedere nella prima riunione. Non scegli un modello contro di loro, scegli un modello che li possa ospitare.
Quali modelli di isolamento esistono?
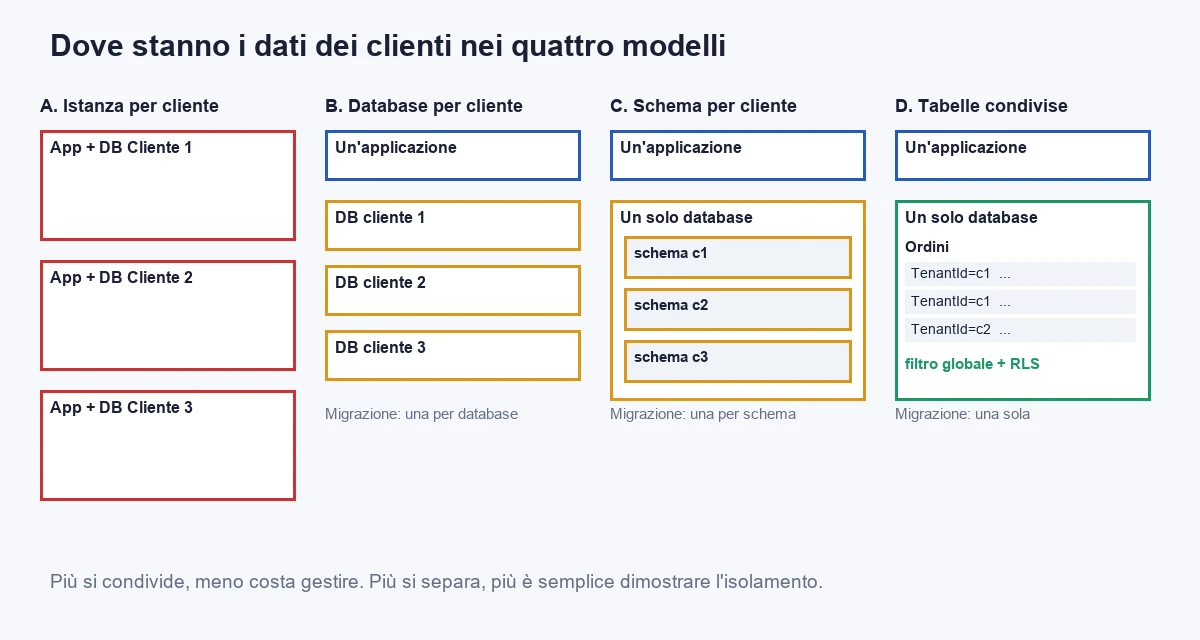
Le strade vere sono quattro, più una variante che le combina. Le chiamo con una lettera per poterle confrontare.
A. Un'istanza completa per ogni cliente
Ogni cliente ha la sua applicazione e il suo database, in un contenitore o in una macchina propria. È il modello più semplice da capire e da costruire: il codice è quello che hai già, non cambia una riga, e un cliente non può in nessun modo vedere i dati di un altro perché non condividono niente.
Il prezzo si paga dopo. Ogni cliente in più è un'installazione in più da aggiornare, da monitorare, da far ripartire quando si blocca. Con dieci clienti è gestibile. Con quaranta, qualcuno nel team fa il proprio lavoro a tempo pieno solo per tenerle allineate.
B. Un database per ogni cliente, una sola applicazione
L'applicazione è una, e a ogni richiesta sceglie a quale database collegarsi in base al cliente. I dati sono separati fisicamente, quindi puoi fare backup, ripristino e cancellazione di un solo cliente con un'operazione semplice. È una forma molto amata da chi vende a clienti regolamentati.
La fatica sta nelle migrazioni. Ogni volta che cambi una tabella, devi applicare la modifica a tutti i database, e devi decidere che cosa fai se su uno dei quaranta fallisce. Con Azure SQL esistono i pool elastici, che dividono le risorse fra molti database e rendono il costo ragionevole, ma la gestione resta quella di quaranta oggetti.
C. Uno schema per ogni cliente, dentro un solo database
Un solo database, e dentro tante "cartelle" (gli schemi di SQL Server), una per cliente, con le stesse tabelle ripetute. Costa meno del modello B perché c'è un solo database da pagare. Ma le migrazioni sono ancora una per schema, e con centinaia di clienti le tabelle diventano decine di migliaia, e gli strumenti cominciano a rallentare. È una via di mezzo che raramente è la migliore, e che incontro soprattutto nei prodotti scritti senza un piano.
D. Tabelle condivise, con una colonna che dice di chi è la riga
Un solo database, un solo insieme di tabelle. Ogni tabella ha una colonna con l'identificativo del cliente, e ogni query è obbligata a filtrare per quella colonna. È il modello più economico e più semplice da far evolvere, perché c'è una sola migrazione per tutti. È anche quello in cui l'errore, se avviene, costa di più: un filtro dimenticato espone i dati di tutti.
Il resto dell'articolo mostra come si rende questo errore molto difficile da fare, con tre difese indipendenti. Con quelle, il modello D è, a 40 clienti, il più conveniente per un prodotto come il nostro.
E. La variante: condiviso per tutti, dedicato per chi lo pretende
È il modello D con un'eccezione dichiarata: i clienti che per contratto vogliono la separazione fisica ricevono un database tutto loro, con la stessa applicazione. Si costruisce una volta e si usa quando serve. Per l'azienda tipo, con quattro clienti su quaranta in questa situazione, è la scelta realistica.
Una nota su dove stanno questi modelli fra le scelte di architettura più grandi: è la stessa famiglia di decisioni di cui parlo nella guida su Clean Architecture e over-engineering. Si sceglie la forma più semplice che regge i vincoli veri, non quella più elegante.
Quanto costa ogni modello in tre anni?
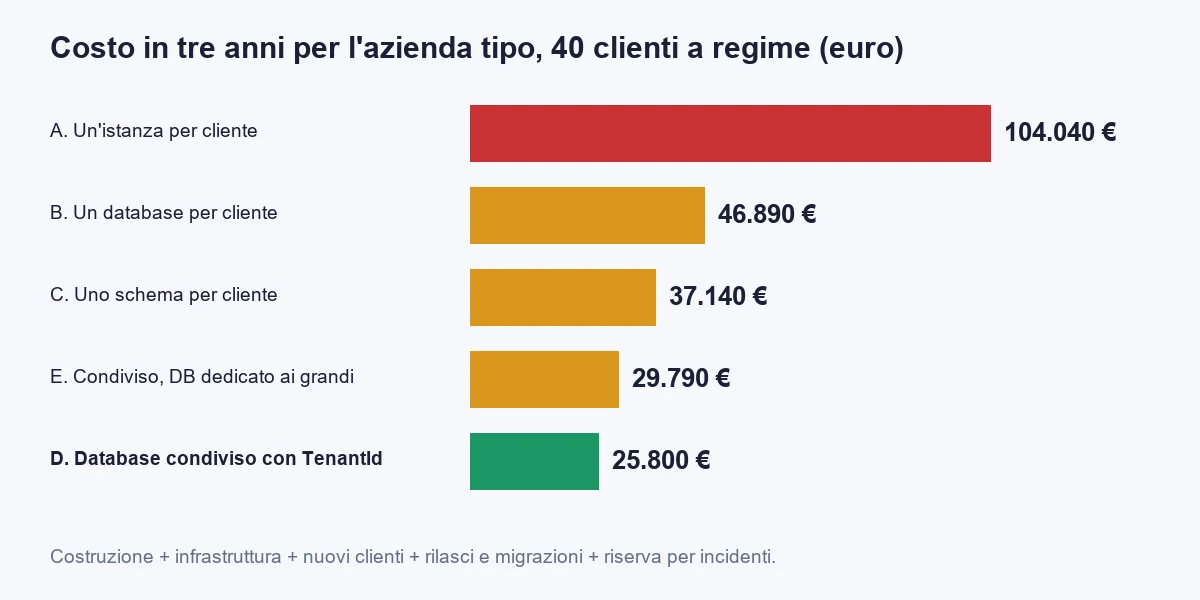
Il conto ha cinque voci per ogni strada. Quattro sono costi che si pagano ogni volta, la quinta è una riserva.
- Costruzione. Le giornate di sviluppo per far funzionare il modello, a 480 euro.
- Infrastruttura. Quanto costa tenere acceso un cliente: contenitori, database, spazio. Si moltiplica per i 900 mesi-cliente del periodo (75 clienti-anno per dodici).
- Nuovi clienti. Le ore che servono per attivare un cliente nuovo, per 40 clienti, a 60 euro.
- Rilasci e migrazioni. Le ore per portare ogni rilascio a ogni cliente, sui 75 clienti-anno.
- Riserva per incidenti. Un importo prudente per il costo atteso di un problema di isolamento o di una migrazione fallita: ore di correzione, comunicazione ai clienti, qualche rimborso.
Ecco i numeri per ogni strada, per l'azienda tipo.
| Strada | Costruzione | Infrastruttura | Nuovi clienti | Rilasci e migrazioni | Riserva | Totale in 3 anni |
|---|---|---|---|---|---|---|
| A. Istanza per cliente | 3.840 (8 giornate) | 54.000 (60 euro per cliente al mese) | 19.200 (8 ore l'uno) | 27.000 (6 ore per cliente l'anno) | 0 | 104.040 |
| B. Database per cliente | 9.600 (20 giornate) | 19.800 (22 euro, con pool elastico) | 4.800 (2 ore) | 11.250 (2,5 ore) | 1.440 | 46.890 |
| C. Schema per cliente | 10.560 (22 giornate) | 5.400 (6 euro) | 4.800 (2 ore) | 13.500 (3 ore) | 2.880 | 37.140 |
| D. Condiviso con filtro | 14.400 (30 giornate) | 2.700 (3 euro) | 600 (un quarto d'ora) | 900 (12 minuti) | 7.200 | 25.800 |
| E. Condiviso più dedicato ai grandi | 18.240 (38 giornate) | 4.500 (5 euro in media) | 1.200 (mezz'ora) | 2.250 (30 minuti) | 3.600 | 29.790 |
Come leggere la tabella. L'istanza per cliente costa il quadruplo del modello condiviso. La differenza, 78.240 euro in tre anni, è quasi tutta infrastruttura e lavoro ripetuto: non c'è niente di tecnicamente brillante, è solo il costo di fare quaranta volte la stessa cosa.
Il modello D è il più economico, ma ha la riserva più alta, 7.200 euro, perché è quello in cui un errore pesa di più. Ho messo quindici giornate l'anno per ogni incidente atteso, fra correzione, spiegazioni ai clienti e rimborsi. Se le tre difese del modello D sono costruite bene, come vedremo, la riserva non si usa. Ma non la tolgo dal conto: chi la toglie sta barando.
Il modello E costa 3.990 euro più del D. È il prezzo di poter dire "sì" a quattro clienti che chiedono la separazione fisica. Se avessi risposto "sì" a loro con il modello B per tutti, avresti speso 21.090 euro più del D. Questa è la cosa da ricordare: la separazione per chi la pretende costa poche migliaia di euro, non decine di migliaia, se la prevedi fin dall'inizio.
Tre avvertenze sui conti.
- Le cifre per cliente al mese sono ordini di grandezza che ho sotto mano da progetti reali su Azure. I listini cambiano: rifai il calcolo con i tuoi preventivi.
- Le giornate di costruzione sono stime per un team che conosce il prodotto. Se il tuo codice è pieno di query scritte a mano, il modello D costa di più, perché bisogna toccarle una per una. Nel piano di quarantacinque giorni più avanti ti mostro come contarle.
- Non ho messo il costo del supporto, perché è simile in tutti i modelli. Ho messo invece, per prudenza, la riserva per gli incidenti: nei modelli A e B è bassa perché i dati sono fisicamente separati, e alta nel D perché non lo sono.
Qual è il numero che decide quale scegliere?
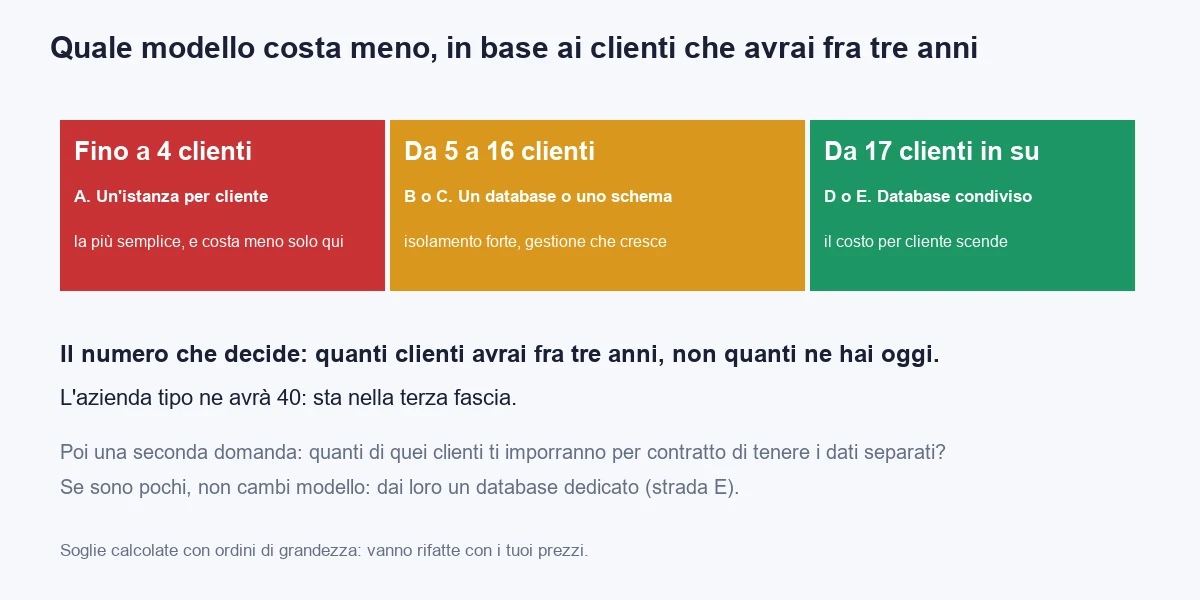
Il numero che decide è uno: quanti clienti avrai fra tre anni. Non quanti ne hai oggi. Chi decide in base ai clienti di oggi sceglie il modello più semplice, e fra tre anni lo paga caro.
Rifacendo il conto per valori diversi di clienti finali, le strade si incrociano in punti precisi.
| Clienti fra tre anni | Strada che costa meno | Perché |
|---|---|---|
| Fino a 4 | A. Un'istanza per cliente | Il codice non cambia, e le ripetizioni sono ancora poche. A 4 clienti l'istanza costa circa 14.800 euro, contro 15.600 del database per cliente |
| Da 5 a 16 | B o C. Un database o uno schema per cliente | Il lavoro di costruzione viene ripagato dai costi bassi per cliente. B e C si equivalgono intorno ai 7 clienti |
| Da 17 in su | D o E. Condiviso | Il costo per cliente scende e la fatica di migrazione quasi sparisce. A 17 clienti il condiviso supera lo schema per cliente |
Quindi per i 40 clienti dell'azienda tipo la risposta è il condiviso, con la variante per i quattro grandi. Se i clienti attesi fossero 8, la risposta sarebbe un database per cliente. Se fossero 3, andrebbe benissimo restare con un'istanza ciascuno, e ti consiglierei di non riscrivere niente.
C'è un secondo numero, che non cambia il modello ma cambia la variante: quanti dei clienti ti imporranno per contratto la separazione fisica. Se sono pochi, basta il modello E. Se sono tutti, perché vendi solo a banche o a enti pubblici, il modello giusto è il B e basta, e non ha senso sforzarsi di condividere.
Un controllo che prende venti minuti. Prendi i tuoi ultimi dieci contratti, o i dieci prossimi che speri di firmare, e cerca tre parole: "ubicazione dei dati", "segregazione", "audit". Se compaiono in più di due contratti su dieci, il tuo mercato chiede separazione e il conto cambia.
Un'ultima osservazione, che la tabella non dice ma che pesa. Il costo della sbagliata scelta non è simmetrico. Se scegli il condiviso e ti serve la separazione, passi al modello E con qualche settimana di lavoro. Se scegli l'istanza per cliente e ti servono quaranta clienti, devi riscrivere l'accesso ai dati di tutto il prodotto. Nel dubbio, scegli la strada da cui si torna indietro più facilmente: il condiviso con la porta aperta al dedicato.
Come si costruisce il modello condiviso in ASP.NET Core?
Il modello condiviso si regge su tre pezzi: riconoscere il cliente a ogni richiesta, filtrare ogni lettura senza doverlo scrivere ogni volta, e marcare ogni scrittura con il cliente giusto. Li costruisco uno alla volta. Il codice compila con .NET 10 dopo aver installato il pacchetto Microsoft.EntityFrameworkCore.SqlServer.
Primo pezzo: il contesto del cliente
Un oggetto con durata di una richiesta che sa quale cliente sta lavorando. Tutto il resto del programma lo legge da lì, e solo il codice che riconosce il cliente può scriverlo.
namespace Gestionale.Clienti;

public interface IContestoCliente
{
    Guid? ClienteId { get; }
}

public sealed class ContestoCliente : IContestoCliente
{
    public Guid? ClienteId { get; set; }
}

public sealed record ClienteCatalogo(Guid Id, string Sottodominio, bool Attivo);

public interface ICatalogoClienti
{
    Task<ClienteCatalogo?> TrovaPerSottodominioAsync(string sottodominio, CancellationToken token);
}
Il catalogo è l'elenco dei clienti: sta in un database a parte, piccolo, e va tenuto in memoria per qualche minuto, perché lo si interroga a ogni richiesta. Nota la scelta del tipo Guid?: se il cliente non è stato riconosciuto, il valore è vuoto, e vedremo che con valore vuoto il sistema non restituisce niente. Un errore deve produrre meno dati, non più dati.
Secondo pezzo: il riconoscimento, in un middleware
Il cliente si riconosce in modo diverso a seconda del prodotto: dal sottodominio (acme.tuoprodotto.it), da un'intestazione, da un'informazione dentro il token di accesso. Il sottodominio è la forma più comune e più comprensibile per gli utenti.
namespace Gestionale.Clienti;

public sealed class RiconoscimentoCliente(RequestDelegate successivo)
{
    public async Task InvokeAsync(
        HttpContext http,
        ContestoCliente contesto,
        ICatalogoClienti catalogo)
    {
        var host = http.Request.Host.Host;
        var sottodominio = host.Split('.')[0];

        var cliente = await catalogo.TrovaPerSottodominioAsync(sottodominio, http.RequestAborted);
        if (cliente is null || !cliente.Attivo)
        {
            http.Response.StatusCode = StatusCodes.Status404NotFound;
            return;
        }

        contesto.ClienteId = cliente.Id;
        await successivo(http);
    }
}
Due dettagli che fanno la differenza. Il primo: se il cliente non esiste o è disattivato, la risposta è un 404 e il resto dell'applicazione non viene eseguito. Non esiste un percorso in cui la richiesta prosegue "senza cliente". Il secondo: la risposta non distingue "il cliente non esiste" da "il cliente è sospeso", così chi prova a indovinare i sottodomini non impara niente.
Un avvertimento sulla sicurezza. Il sottodominio da solo dice quale cliente si vuole raggiungere, non dice che l'utente ne faccia parte. L'autenticazione deve poi verificare che l'utente appartenga a quel cliente, e il controllo va fatto sul lato server. Chi ha un account nel cliente A e cambia a mano il sottodominio in quello del cliente B non deve entrare. Lo si copre con una regola nell'autorizzazione: l'identificativo del cliente scritto nel token deve coincidere con quello del contesto.
Terzo pezzo: il filtro che non si può dimenticare
Entity Framework Core offre una funzione fatta apposta, il filtro globale di query: una condizione che viene aggiunta in automatico a ogni lettura di una certa entità. È la prima difesa, e la più importante.
using Gestionale.Clienti;
using Microsoft.EntityFrameworkCore;

namespace Gestionale.Dati;

public interface IDelCliente
{
    Guid ClienteId { get; set; }
}

public class Ordine : IDelCliente
{
    public int Id { get; set; }
    public Guid ClienteId { get; set; }
    public string Numero { get; set; } = "";
    public decimal Totale { get; set; }
}

public class GestionaleDb(DbContextOptions<GestionaleDb> opzioni, IContestoCliente contesto)
    : DbContext(opzioni)
{
    public DbSet<Ordine> Ordini => Set<Ordine>();

    private Guid? ClienteCorrente => contesto.ClienteId;

    protected override void OnModelCreating(ModelBuilder modello)
    {
        modello.Entity<Ordine>(e =>
        {
            e.HasQueryFilter(o => o.ClienteId == ClienteCorrente);
            e.HasIndex(o => new { o.ClienteId, o.Numero }).IsUnique();
            e.Property(o => o.Totale).HasPrecision(18, 2);
        });
    }

    public override int SaveChanges(bool accettaTutteLeModifiche)
    {
        ControllaEMarca();
        return base.SaveChanges(accettaTutteLeModifiche);
    }

    public override Task<int> SaveChangesAsync(bool accettaTutteLeModifiche, CancellationToken token = default)
    {
        ControllaEMarca();
        return base.SaveChangesAsync(accettaTutteLeModifiche, token);
    }

    private void ControllaEMarca()
    {
        var cliente = contesto.ClienteId
            ?? throw new InvalidOperationException("Nessun cliente nel contesto: scrittura rifiutata.");

        foreach (var voce in ChangeTracker.Entries<IDelCliente>())
        {
            if (voce.State == EntityState.Added)
            {
                voce.Entity.ClienteId = cliente;
            }
            else if (voce.State == EntityState.Modified && voce.Property(x => x.ClienteId).IsModified)
            {
                throw new InvalidOperationException("Non si può spostare una riga a un altro cliente.");
            }
        }
    }
}
Che cosa fa questo codice, riga per riga, in parole semplici.
- Ogni lettura di
Ordiniriceve da sola la condizione "il cliente della riga è quello del contesto". Chi scrivedb.Ordini.ToList()non deve ricordarsene. - Se il cliente nel contesto è vuoto, la condizione non è mai vera e la lettura restituisce zero righe. È il comportamento giusto: in caso di dubbio, niente dati.
- Ogni scrittura è marcata dal sistema. Una riga aggiunta riceve il cliente del contesto, quindi nessun programmatore può dimenticare di impostarlo, né impostarlo sbagliato.
- Una scrittura senza cliente è un errore, non un'omissione. Il salvataggio fallisce con un messaggio chiaro.
- Una riga non si può spostare a un altro cliente. Se qualcuno prova a cambiare
ClienteIda una riga esistente, il salvataggio si rifiuta. - L'indice unico comprende il cliente. Il numero ordine "A-1" può esistere una volta per cliente, non una volta in tutto il sistema, che è esattamente quello che i clienti si aspettano.
Ora si registra tutto nella partenza dell'applicazione.
using Gestionale.Clienti;
using Gestionale.Dati;
using Microsoft.EntityFrameworkCore;

var builder = WebApplication.CreateBuilder(args);

builder.Services.AddScoped<ContestoCliente>();
builder.Services.AddScoped<IContestoCliente>(sp => sp.GetRequiredService<ContestoCliente>());
builder.Services.AddSingleton<ICatalogoClienti, CatalogoClientiInMemoria>();

builder.Services.AddDbContext<GestionaleDb>(opzioni =>
    opzioni.UseSqlServer(builder.Configuration.GetConnectionString("Gestionale")));

var app = builder.Build();

app.UseMiddleware<RiconoscimentoCliente>();

app.MapGet("/ordini", async (GestionaleDb db) =>
    await db.Ordini.OrderBy(o => o.Numero).Select(o => new { o.Numero, o.Totale }).ToListAsync());

app.Run();

public sealed class CatalogoClientiInMemoria : ICatalogoClienti
{
    private static readonly ClienteCatalogo[] Clienti =
    [
        new(Guid.Parse("11111111-1111-1111-1111-111111111111"), "acme", true),
        new(Guid.Parse("22222222-2222-2222-2222-222222222222"), "beta", true),
    ];

    public Task<ClienteCatalogo?> TrovaPerSottodominioAsync(string sottodominio, CancellationToken token) =>
        Task.FromResult(Clienti.FirstOrDefault(c => c.Sottodominio == sottodominio));
}
Il catalogo qui è fisso, per far girare l'esempio. In produzione legge da una tabella e tiene la risposta in memoria per cinque minuti.
Il punto da osservare è l'endpoint /ordini: non nomina mai il cliente. Chi lo scrive non può sbagliare, perché non c'è niente da ricordare. Questo è l'obiettivo di tutto il modello: la sicurezza non deve dipendere dalla memoria di chi scrive il codice.
Come si impedisce che un dato esca dal cliente sbagliato?
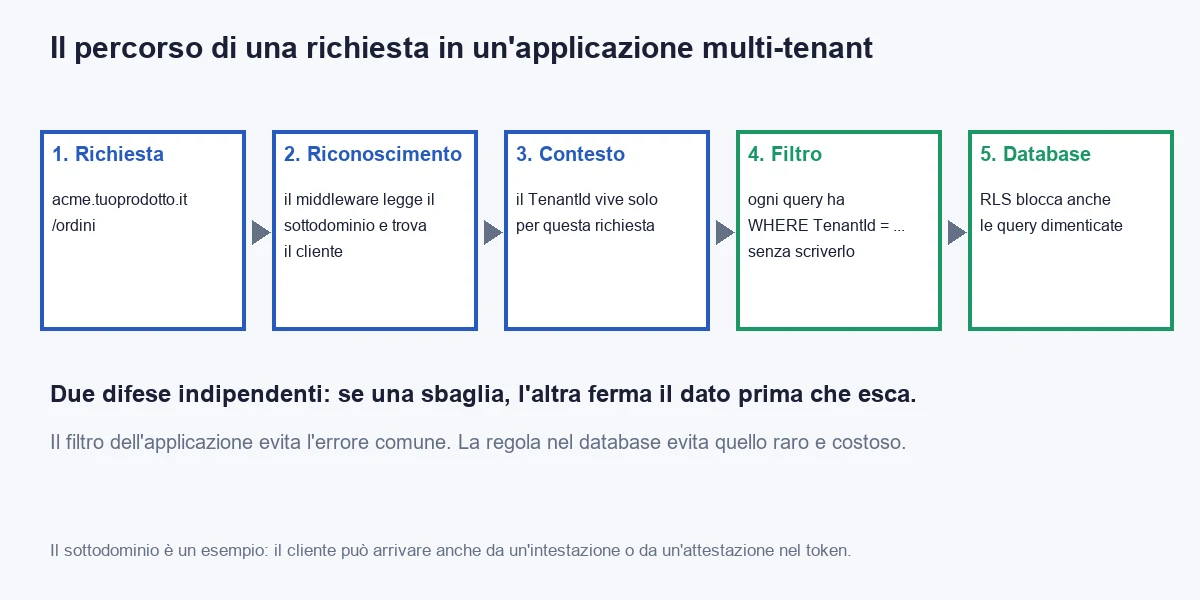
Il filtro globale è una buona difesa, ma è una sola. Ci sono almeno tre modi in cui un dato può uscire comunque: un programmatore usa IgnoreQueryFilters() per una ricerca amministrativa e se lo dimentica nel posto sbagliato; una query scritta a mano in SQL bypassa Entity Framework; un'altra applicazione (un report, un'esportazione, uno strumento di BI) si collega direttamente al database.
Per questo non ne basta una. Il modello condiviso regge solo con tre difese indipendenti: una nel codice, una nel database, una nei test.
Seconda difesa: la sicurezza a livello di riga nel database
SQL Server e Azure SQL offrono la Row-Level Security: una regola scritta nel database che filtra le righe in base a un valore che l'applicazione imposta all'apertura della connessione. Se l'applicazione, per un errore, dimentica il filtro, il database lo applica comunque.
CREATE SCHEMA Sicurezza;
GO

CREATE FUNCTION Sicurezza.FiltroCliente(@ClienteId uniqueidentifier)
RETURNS TABLE
WITH SCHEMABINDING
AS
RETURN
    SELECT 1 AS Consentito
    WHERE @ClienteId = CAST(SESSION_CONTEXT(N'ClienteId') AS uniqueidentifier);
GO

CREATE SECURITY POLICY Sicurezza.PoliticaCliente
    ADD FILTER PREDICATE Sicurezza.FiltroCliente(ClienteId) ON dbo.Ordini,
    ADD BLOCK PREDICATE Sicurezza.FiltroCliente(ClienteId) ON dbo.Ordini AFTER INSERT
WITH (STATE = ON);
GO
Il predicato di filtro nasconde le righe degli altri clienti in lettura, in modifica e in cancellazione. Il predicato di blocco impedisce di inserire una riga con il cliente sbagliato. Il valore ClienteId lo scrive l'applicazione nel contesto della sessione appena apre la connessione. In Entity Framework si fa con un intercettore, che si inserisce una volta e vale per tutte le query.
using System.Data.Common;
using Gestionale.Clienti;
using Microsoft.EntityFrameworkCore.Diagnostics;

namespace Gestionale.Dati;

public sealed class ContestoSessioneInterceptor(IContestoCliente contesto) : DbConnectionInterceptor
{
    private const string Comando =
        "EXEC sp_set_session_context @key = N'ClienteId', @value = @valore, @read_only = 1;";

    public override void ConnectionOpened(DbConnection connessione, ConnectionEndEventData dati)
    {
        using var comando = Prepara(connessione);
        comando.ExecuteNonQuery();
    }

    public override async Task ConnectionOpenedAsync(
        DbConnection connessione, ConnectionEndEventData dati, CancellationToken token = default)
    {
        await using var comando = Prepara(connessione);
        await comando.ExecuteNonQueryAsync(token);
    }

    private DbCommand Prepara(DbConnection connessione)
    {
        var comando = connessione.CreateCommand();
        comando.CommandText = Comando;

        var parametro = comando.CreateParameter();
        parametro.ParameterName = "@valore";
        parametro.Value = contesto.ClienteId is { } id ? id : DBNull.Value;
        comando.Parameters.Add(parametro);

        return comando;
    }
}
Si registra insieme al contesto: services.AddScoped<ContestoSessioneInterceptor>() e, nell'AddDbContext, .AddInterceptors(sp.GetRequiredService<ContestoSessioneInterceptor>()). Il parametro @read_only = 1 impedisce a un'istruzione iniettata di cambiare il valore durante la sessione. Quando la connessione torna nel gruppo (il pooling di .NET), SQL Server azzera il contesto, quindi un cliente non eredita quello di un altro.
Tre avvertenze sulla sicurezza a livello di riga, che nei progetti vedo sbagliare.
- L'utente del database dell'applicazione non deve essere proprietario. Chi può modificare la politica può spegnerla. L'applicazione si collega con un utente che ha solo i permessi di lettura e scrittura sulle tabelle. Le migrazioni si eseguono con un altro utente.
- Il costo in prestazioni è basso, ma non è zero. Su tabelle grandi serve un indice che parta dalla colonna del cliente, come quello nell'esempio. Provalo sulle tue tabelle più grosse, con dati veri, prima di mettere in produzione.
- Va attivata su ogni tabella dei clienti, e va verificata. Una tabella nuova senza politica è una tabella aperta. Nella pipeline un controllo confronta l'elenco delle tabelle con la colonna
ClienteIde l'elenco delle tabelle con una politica, e si ferma se non coincidono.
Terza difesa: il test che ti ferma prima che sia troppo tardi
Le prime due difese funzionano finché qualcuno non le rompe. Il test è quello che si accorge che sono state rotte. Costa mezz'ora una volta e gira a ogni rilascio. Il test usa SQLite in memoria, che non richiede un server, e verifica le due regole che non devono mai cedere.
using Gestionale.Clienti;
using Gestionale.Dati;
using Microsoft.Data.Sqlite;
using Microsoft.EntityFrameworkCore;
using Xunit;

namespace Gestionale.Test;

public class IsolamentoClientiTest
{
    private static (SqliteConnection Connessione, DbContextOptions<GestionaleDb> Opzioni) Prepara()
    {
        var connessione = new SqliteConnection("DataSource=:memory:");
        connessione.Open();
        var opzioni = new DbContextOptionsBuilder<GestionaleDb>().UseSqlite(connessione).Options;
        return (connessione, opzioni);
    }

    private static GestionaleDb Apri(DbContextOptions<GestionaleDb> opzioni, Guid? cliente) =>
        new(opzioni, new ContestoCliente { ClienteId = cliente });

    [Fact]
    public async Task Un_cliente_non_vede_i_dati_di_un_altro()
    {
        var (connessione, opzioni) = Prepara();
        using var _ = connessione;
        var acme = Guid.NewGuid();
        var beta = Guid.NewGuid();

        using (var db = Apri(opzioni, acme))
        {
            await db.Database.EnsureCreatedAsync();
            db.Ordini.Add(new Ordine { Numero = "A-1", Totale = 100m });
            await db.SaveChangesAsync();
        }

        using (var db = Apri(opzioni, beta))
        {
            db.Ordini.Add(new Ordine { Numero = "B-1", Totale = 250m });
            await db.SaveChangesAsync();
        }

        using (var db = Apri(opzioni, acme))
        {
            var visibili = await db.Ordini.ToListAsync();
            Assert.Single(visibili);
            Assert.Equal("A-1", visibili[0].Numero);
        }
    }

    [Fact]
    public async Task Senza_cliente_non_si_legge_e_non_si_scrive()
    {
        var (connessione, opzioni) = Prepara();
        using var _ = connessione;

        using (var db = Apri(opzioni, Guid.NewGuid()))
        {
            await db.Database.EnsureCreatedAsync();
            db.Ordini.Add(new Ordine { Numero = "A-1", Totale = 100m });
            await db.SaveChangesAsync();
        }

        using var senzaCliente = Apri(opzioni, null);
        Assert.Empty(await senzaCliente.Ordini.ToListAsync());

        senzaCliente.Ordini.Add(new Ordine { Numero = "X-1", Totale = 1m });
        await Assert.ThrowsAsync<InvalidOperationException>(() => senzaCliente.SaveChangesAsync());
    }

    [Fact]
    public void Ogni_lettura_porta_la_condizione_sul_cliente()
    {
        var (connessione, opzioni) = Prepara();
        using var _ = connessione;
        using var db = Apri(opzioni, Guid.NewGuid());

        var sql = db.Ordini.ToQueryString();

        Assert.Contains("WHERE", sql);
    }
}
Il primo test dice: "il cliente Acme ha un ordine, Beta ne ha un altro, e Acme vede solo il suo". Il secondo dice: "senza un cliente riconosciuto non si legge niente e non si scrive niente". Il terzo è un guardiano: se qualcuno toglie il filtro globale, la query perde la condizione e il test si rompe.
Per le entità aggiunte in futuro conviene un test che le scorra tutte, ma richiede un po' di attenzione ai nomi delle funzioni di Entity Framework, che cambiano fra le versioni. Più semplice e più robusto: nella pipeline, una ricerca nel codice che segnala ogni uso di IgnoreQueryFilters e blocca il rilascio se la riga non ha un commento di approvazione. Poche righe, e la funzione che più spesso causa i problemi diventa una decisione consapevole.
Nell'insieme: il filtro nel codice protegge dall'errore comune, la regola nel database dalle query scritte a mano e dagli strumenti collegati dall'esterno, il test da chi un giorno rompe le prime due. Nessuna è sufficiente da sola. Insieme costano le trenta giornate della tabella, e sono quello che ti permette di dormire.
Che cosa si dimentica quasi sempre?
La parte che fa notizia è il filtro sulle query. La parte che causa gli incidenti, nella mia esperienza, è tutto ciò che sta fuori dalle query. Sono nove punti, e li passo uno per uno perché ognuno è già costato soldi a qualcuno.
- I lavori in background. Un'elaborazione notturna non ha una richiesta web, quindi non ha un sottodominio e non ha un contesto. Se la scrivi per girare "su tutti i clienti", deve entrare in ciascun cliente in modo esplicito, impostare il contesto e lavorare dentro quello. Un lavoro che gira senza contesto, con il filtro che restituisce zero righe, non fa niente e non segnala niente: il guasto più silenzioso che esista. Il lavoro deve fallire a voce alta se il contesto manca.
- La cache. Una chiave come
"listino"in una cache condivisa serve a tutti il listino del primo cliente che l'ha chiesto. Ogni chiave di cache comprende l'identificativo del cliente:$"{cliente}:listino". È l'errore più semplice da fare e uno dei più gravi. - I file. I documenti caricati dagli utenti vanno in un percorso che comincia con l'identificativo del cliente, e il download controlla che la richiesta provenga da quel cliente. Un indirizzo del tipo
/documenti/48213con un numero progressivo si indovina in dieci minuti. - La posta in uscita. Le email partono con il nome del cliente giusto, il modello giusto e l'indirizzo di risposta giusto. Un messaggio inviato a un cliente con il logo di un altro non è un incidente di sicurezza, ma finisce nelle recensioni.
- La ricerca e gli indici. Se usi un motore di ricerca esterno, ogni documento indicizzato porta il cliente, e ogni ricerca filtra su quel campo. Il filtro di Entity Framework non protegge niente che non passi da Entity Framework.
- I report e le esportazioni. Un report scritto a mano con SQL è il percorso più comune verso un'esposizione. Si scrive sugli stessi oggetti protetti, oppure si fa girare con una connessione che imposta il contesto, così la regola del database lo copre.
- I registri. Ogni riga di registro porta l'identificativo del cliente. Senza, non puoi rispondere alla domanda "che cosa è successo a questo cliente alle 14:20", e il cliente la farà. In ASP.NET Core si ottiene con un ambito di registrazione aperto nel middleware.
- Le prestazioni fra clienti. Un cliente che lancia un'esportazione enorme rallenta tutti gli altri. Servono limiti per cliente: numero di richieste al minuto, dimensione massima delle esportazioni, tempo massimo delle query. ASP.NET Core ha un limitatore di richieste che accetta una chiave di partizione, e la chiave giusta è il cliente.
- Le chiavi esterne fra clienti. Una riga del cliente A può puntare, per un errore, a un'anagrafica del cliente B se la chiave esterna comprende solo il numero progressivo. Le chiavi composte, o un controllo in scrittura, chiudono il buco.
Il filo che unisce i nove punti è lo stesso della prima parte: ciò che dipende dalla memoria di una persona prima o poi si rompe. Ogni volta che trovi un punto in cui il cliente va "ricordato", fai in modo che manchi un controllo automatico, non un promemoria nella documentazione.
Come si gestiscono migrazioni, backup e cancellazione di un cliente?
Sono le tre operazioni che si fanno poche volte e vanno male quando capitano. Il modello condiviso le semplifica o le complica, a seconda del caso.
Le migrazioni dello schema
Nel modello D c'è un solo database e una sola migrazione per rilascio. È il vantaggio più grande e il motivo per cui il costo di rilasci e migrazioni scende da 27.000 a 900 euro. Nei modelli B e C, la migrazione è un ciclo.
using Gestionale.Clienti;
using Gestionale.Dati;
using Microsoft.EntityFrameworkCore;

namespace Gestionale.Operazioni;

public sealed record ClienteConnessione(Guid Id, string StringaConnessione);

public static class MigrazioniClienti
{
    public static async Task<IReadOnlyList<Guid>> ApplicaATuttiAsync(
        IEnumerable<ClienteConnessione> clienti, CancellationToken token)
    {
        var falliti = new List<Guid>();

        foreach (var cliente in clienti)
        {
            try
            {
                var opzioni = new DbContextOptionsBuilder<GestionaleDb>()
                    .UseSqlServer(cliente.StringaConnessione)
                    .Options;

                await using var db = new GestionaleDb(opzioni, new ContestoCliente { ClienteId = cliente.Id });
                await db.Database.MigrateAsync(token);
            }
            catch (Exception)
            {
                falliti.Add(cliente.Id);
            }
        }

        return falliti;
    }
}
Il ciclo è semplice, ma l'elenco dei falliti è la parte importante. Con 40 database, prima o poi uno su quaranta ha un dato che non accetta la nuova regola. Se il ciclo si ferma al primo errore, hai 17 clienti aggiornati e 23 no, e l'applicazione nuova non funziona con lo schema vecchio. Le regole che uso: migrazioni sempre compatibili all'indietro (si aggiunge, non si toglie, e si toglie solo al rilascio successivo), un elenco dei falliti che blocca il rilascio, e un cliente pilota che le riceve per primo.
Il backup e il ripristino di un solo cliente
Nei modelli A e B, il ripristino di un cliente è un'operazione semplice: si ripristina il suo database, di solito in meno di un'ora. Nel modello D non esiste un backup "di un cliente". C'è il backup di tutto, e per recuperare un cliente che ha cancellato per errore un mese di dati si ripristina il database in un luogo a parte e si copiano le righe di quel cliente. Si fa, ma è un lavoro di mezza giornata e va provato prima che serva.
Questa è una delle ragioni per cui, per i clienti più grandi o più esigenti, il modello E è una buona idea: il loro database separato si ripristina da solo, senza toccare gli altri.
La regola che consiglio: prova un ripristino a tempo, una volta ogni trimestre. Prendi un cliente, simula un errore, ripristina e misura quanto ci metti. Un backup che non hai mai ripristinato è un'ipotesi.
La cancellazione di un cliente
Quando un contratto finisce, il cliente può chiederti di restituire i dati e di cancellarli. Se i dati sono personali, di solito sei il responsabile del trattamento per conto del cliente, e devi poterlo fare, dimostrando di averlo fatto (verifica i dettagli con il tuo consulente legale).
Nel modello B si cancella il database: un comando, poche decine di secondi. Nel modello D serve un elenco di tutte le tabelle con la colonna del cliente e una cancellazione ordinata per rispettare le chiavi esterne, più i file, la cache e gli indici di ricerca. Se non l'hai mai scritto, la prima volta che ti serve lo scrivi in fretta, sotto pressione, e dimentichi un posto.
La soluzione è scrivere la procedura di cancellazione prima del primo cliente, provarla su dati finti e metterla nella pipeline come test: crea un cliente fittizio con dati in ogni tabella, cancellalo, e verifica che non resti niente con il suo identificativo, né nel database né nei file. È lo stesso controllo del filtro, applicato alla fine della vita del cliente.
Come si passa da un'installazione per cliente a un servizio vero?
La riscrittura totale è quasi sempre una pessima idea. Il programma di oggi funziona, e ha sei anni di regole che nessuno ricorda. Il passaggio si fa a gradini, e a ogni gradino hai già qualcosa che funziona. Per l'azienda tipo, con un team di quattro persone, il piano è di quarantacinque giorni lavorativi.
- Giorni 1-3: il conteggio. Si contano le tabelle con dati dei clienti, le query scritte a mano, i punti in cui il codice apre una connessione direttamente, i lavori di notte, le esportazioni. È il numero che muove la stima: se le query a mano sono 15, il modello D costa le giornate della tabella, se sono 150 ne costa il doppio.
- Giorni 4-8: il catalogo dei clienti. Una piccola base dati con l'elenco, il sottodominio, lo stato e, per il modello E, la stringa di connessione dei clienti con database dedicato. Anche senza multi-tenant, serve a tutto il resto.
- Giorni 9-14: la colonna del cliente. Si aggiunge
ClienteIda ogni tabella, con un valore per i dati esistenti (ogni installazione ha già un solo cliente), un indice e la chiave unica corretta. Migrazioni compatibili all'indietro. - Giorni 15-20: il contesto e il filtro. Il middleware, il contesto, il filtro globale, la marcatura delle scritture. Si prova tutto con due clienti finti.
- Giorni 21-26: le query scritte a mano. Ogni SQL a mano viene riscritto sugli oggetti protetti, oppure eseguito su una connessione che imposta il contesto. È la parte più lunga e più noiosa. Si fa con calma.
- Giorni 27-31: la regola nel database. La politica di sicurezza a livello di riga, l'intercettore, l'utente con soli permessi di lettura e scrittura. Si provano le prestazioni sulle tabelle più grandi con dati veri.
- Giorni 32-36: tutto ciò che sta fuori dalle query. I nove punti dell'elenco: lavori di notte, cache, file, posta, ricerca, report, registri, limiti, chiavi.
- Giorni 37-40: i test e la procedura di cancellazione. I tre test di isolamento, il test di cancellazione del cliente fittizio, il controllo sulle tabelle con la politica.
- Giorni 41-45: il pilota. Un cliente vero, il più tollerante, passa dal vecchio al nuovo in una sera. Gli altri restano dov'erano. Si guarda per due settimane. Poi, un cliente alla volta, si migrano gli altri.
Il piano di ritorno costa poco finché i clienti non sono migrati: il programma vecchio gira ancora, con la colonna aggiuntiva che non disturba. Si abbandona il vecchio solo quando l'ultimo cliente è sul nuovo da un mese.
Una nota sulle persone, che pesa più del codice. Il giorno in cui il programma diventa un servizio, il team smette di "consegnare un'installazione" e comincia a "gestire un servizio acceso": reperibilità, monitoraggio, comunicazioni ai clienti in caso di problema, finestre di manutenzione. Non è un cambiamento tecnico, è un cambiamento di mestiere. Preparalo in anticipo, perché è lì che i passaggi al SaaS si inceppano più spesso.
Quali errori evitare quando si costruisce un prodotto multi-tenant?
Gli errori che vedo più spesso, e che costano di più, sono otto.
- Affidarsi a una sola difesa. Il filtro nel codice senza la regola nel database funziona finché il team è piccolo e attento. Cinque anni dopo, con un programmatore nuovo e una scadenza, non basta più.
- Scegliere in base ai clienti di oggi. Con otto clienti l'istanza per ciascuno sembra ragionevole. Il prodotto dovrà reggere quaranta.
- Dimenticare i lavori in background. Girano senza contesto, e il filtro, correttamente, non restituisce niente. Il guasto si scopre quando un cliente chiede perché le fatture automatiche non sono partite.
- Usare
IgnoreQueryFilterssenza un controllo. È la scorciatoia più comoda e la più pericolosa. Ogni uso è una decisione, e le decisioni vanno scritte. - Non provare il ripristino. Il backup c'è, il ripristino di un cliente solo non l'ha mai provato nessuno. Lo scopri la prima volta che serve.
- Mettere il cliente nell'indirizzo e fidarsi. Il sottodominio dice quale cliente si vuole raggiungere. Chi è l'utente e a quale cliente appartiene lo dice il token, e il server deve controllarlo.
- Promettere la separazione fisica a tutti. Un database per ognuno è un impegno di gestione per anni. Lo si offre a chi lo paga, con un listino diverso, non a chiunque lo chieda.
- Costruire l'ottimizzazione prima del bisogno. Sharding, database per fascia di clienti, regioni diverse. Con 40 clienti non servono. Si progettano le porte, non si costruiscono le stanze.
La regola che li riassume: un'architettura multi-tenant è fatta di barriere automatiche, non di buone intenzioni. Se un errore è possibile per distrazione, prima o poi si verifica. Il tuo lavoro è rendere la distrazione innocua.
Quando conviene non costruire un prodotto multi-tenant?
Capita spesso, ed è una buona notizia. Ci sono quattro situazioni in cui l'istanza per cliente è la scelta giusta, e te le dico apertamente.
- Hai pochi clienti e ne avrai pochi. Fino a 4 clienti l'istanza costa meno, e ogni euro speso in architettura è sottratto al prodotto. Se vendi a quattro grandi aziende, con contratti da centomila euro, l'installazione dedicata è una funzione, non un difetto.
- I clienti vogliono personalizzazioni profonde. Se ognuno ha regole sue, campi suoi, flussi suoi, il codice è già diverso per ciascuno. Un'applicazione sola con quaranta varianti diventa un groviglio. Qui sei più vicino al software su misura che a un prodotto, e va gestito come tale: ne parlo nella pagina sul software su misura.
- I vincoli normativi impongono la separazione per tutti. Se il tuo mercato è fatto solo di banche, di enti pubblici o di sanità con regole stringenti, il modello B è la risposta, e va benissimo.
- Il prodotto non è ancora un prodotto. Se hai un cliente solo e speri di averne altri, costruire un'architettura per quaranta è la forma di ottimismo più costosa che esista. Prima si vende il secondo, poi il terzo, poi si decide.
In ognuno di questi casi c'è un minimo che conviene fare comunque, e costa pochi giorni: un catalogo dei clienti, una procedura automatica per attivare un'installazione nuova e un modo unico di aggiornarle tutte. Sono otto giornate, e ti tengono la porta aperta verso il modello condiviso quando i clienti saranno abbastanza.
Se sei arrivato fin qui, probabilmente hai due preventivi sul tavolo, o un cliente che ti chiede di "avere i dati separati" e non sai che cosa rispondere. Prima di decidere, prendi i tuoi numeri: clienti attesi fra tre anni, quanti pretendono la separazione, quante query a mano ci sono nel codice. Mezza giornata, e sai in quale fascia ti trovi.
Se vuoi un secondo sguardo sul tuo caso, la strada è la consulenza software. Se la domanda è se conviene un prodotto in abbonamento o un gestionale su misura per il tuo modo di lavorare, la risposta sta nella guida al gestionale: pacchetto o su misura. E se il costo del cloud è la tua preoccupazione, c'è la guida a come ridurre i costi di Azure senza un team dedicato.
Domande frequenti
È un modo di costruire un programma in modo che una sola applicazione serva più clienti, chiamati tenant, tenendo i dati di ciascuno separati dagli altri. Il cliente vede solo i suoi dati e la sua configurazione, mentre dietro c'è un solo programma da aggiornare, monitorare e far girare.
Per un'azienda con 40 clienti a regime in tre anni, un'istanza per cliente costa circa 104.040 euro, un database per cliente circa 46.890, uno schema per cliente circa 37.140 e il database condiviso con filtro circa 25.800. La differenza è quasi tutta infrastruttura e lavoro ripetuto a ogni rilascio.
Dipende da quanti clienti avrai fra tre anni: fino a 4 conviene un'istanza per cliente, da 5 a 16 un database o uno schema per cliente, da 17 in su un database condiviso. Se alcuni clienti impongono la separazione fisica per contratto, si dà solo a loro un database dedicato.
Con tre difese indipendenti: un filtro globale di query che aggiunge il cliente a ogni lettura, la Row-Level Security nel database che filtra le righe anche per le query dimenticate, e test automatici che si rompono se qualcuno toglie le prime due.
Lavori in background che girano senza un cliente nel contesto, chiavi di cache senza l'identificativo del cliente, file raggiungibili con indirizzi indovinabili, report scritti a mano in SQL, registri senza cliente, limiti di utilizzo per cliente e chiavi esterne che possono puntare a un altro cliente.
Quando i clienti saranno pochi (fino a 4), quando vogliono personalizzazioni profonde, quando il mercato impone la separazione fisica a tutti o quando il prodotto non è ancora un prodotto. In questi casi basta un catalogo dei clienti e una procedura automatica per attivare e aggiornare le installazioni.
Lascia i tuoi dati nel form qui sotto