Qual è il numero che decide se serve Azure Cosmos DB?
Sopra il 90 per cento Cosmos DB è una scelta sensata; fra il 60 e il 90 per cento lo si usa solo per una parte dei dati; sotto il 60 per cento conviene un database relazionale. In un'azienda di manutenzione di 60 persone al 94 per cento, il carico costava circa 19 euro al mese in serverless, contro 1.095 euro della configurazione "per stare tranquilli".
Un'azienda di manutenzione impianti di 60 persone decide di rifare l'app dei tecnici. Il responsabile IT legge che per le applicazioni moderne "si usa Azure Cosmos DB", e chiede un preventivo. Arriva una proposta con due regioni, diecimila unità di throughput "per stare tranquilli" e una fattura prevista di circa 1.100 euro al mese per un database che oggi pesa 32 GB.
Lo stesso carico, configurato per quello che serve davvero, costa circa 19 euro al mese. In certe condizioni anche meno di 2. La differenza non sta nel prodotto: sta in cinque decisioni che nessun preventivo ti spiega.
Questo articolo ti dice che cos'è Azure Cosmos DB, quando in un'azienda italiana conviene e quando è solo un costo mensile con un bel nome, come si calcola la spesa partendo dai tuoi numeri e quali scelte (la chiave di partizione prima di tutte) non si possono correggere dopo.
Troverai la definizione senza gergo, il numero che decide se ti serve, i tre modi di pagare con i conti in euro, il codice C# per un client che regge in produzione, i cinque livelli di consistenza, il confronto onesto con Azure SQL, gli errori che vedo più spesso e un piano in sessanta giorni per provarlo senza rischi.
Una premessa. Dal 1999 progetto software per aziende, quasi sempre in .NET, e da anni la mia regola sul cloud è una sola: spendere il minimo che regge il carico. Nella mia infrastruttura ho accorpato nove database in uno da 4,20 euro al mese. Non ho interessi a venderti Cosmos DB: te lo consiglio solo quando i numeri lo chiedono.
Il caso che uso in tutto l'articolo è un'azienda tipo, costruita con ordini di grandezza e medie di settore: 60 persone, 38 tecnici sul campo con il tablet, 900 impianti dei clienti con un sensore ciascuno, un portale clienti. Non è un cliente, è un metodo. Lo rifai con i tuoi numeri in un pomeriggio.
Che cos'è Azure Cosmos DB, spiegato senza gergo?
Azure Cosmos DB è un database gestito da Microsoft che salva documenti invece di righe. Un documento è un blocco di dati in formato JSON: l'intervento di un tecnico con la sua checklist, i materiali usati e le foto, tutto insieme, in un solo pezzo.
In un database tradizionale (SQL Server, Azure SQL, PostgreSQL) lo stesso intervento è sparso su cinque tabelle e lo ricomponi con i join. Qui lo salvi e lo rileggi intero, per chiave, in pochi millisecondi.
Tre caratteristiche lo rendono diverso da un database che installi tu.
- Si paga a consumo di operazioni, non di macchina. Non c'è un server da dimensionare: ogni lettura e ogni scrittura ha un costo misurato in "unità di richiesta" (RU), e il conto dipende da quante ne consumi.
- Distribuisce i dati da solo. Il database divide i documenti in partizioni, in base a una chiave che scegli tu, e le sposta su più macchine quando crescono. Questo gli permette di scalare quasi senza limiti, e ti obbliga a decidere bene quella chiave.
- Replica nel mondo con un clic. Puoi tenere copie dei dati in più regioni e farle scrivere tutte. È la funzione che giustifica il nome e anche quella che fa salire le fatture.
Esiste in più "modalità" a seconda del linguaggio con cui lo interroghi: la principale è quella per documenti (chiamata NoSQL, con un linguaggio simile a SQL), ma ci sono anche compatibilità con MongoDB, Cassandra, Gremlin per i grafi, Table e PostgreSQL. In questo articolo parlo della principale, quella che incontri nel 90 per cento dei progetti .NET.
Il pacchetto da usare è Microsoft.Azure.Cosmos, l'SDK ufficiale. Esiste anche il provider per Entity Framework Core (Microsoft.EntityFrameworkCore.Cosmos), comodo per chi ha già un modello EF, ma con limiti che vedremo.
Un'ultima definizione, che evita un malinteso comune: Cosmos DB non è "un SQL Server più veloce". È un database fatto per un altro tipo di accesso, e se lo usi come un database relazionale perdi i vantaggi e paghi gli svantaggi.
Qual è il numero che decide se ti serve Cosmos DB?
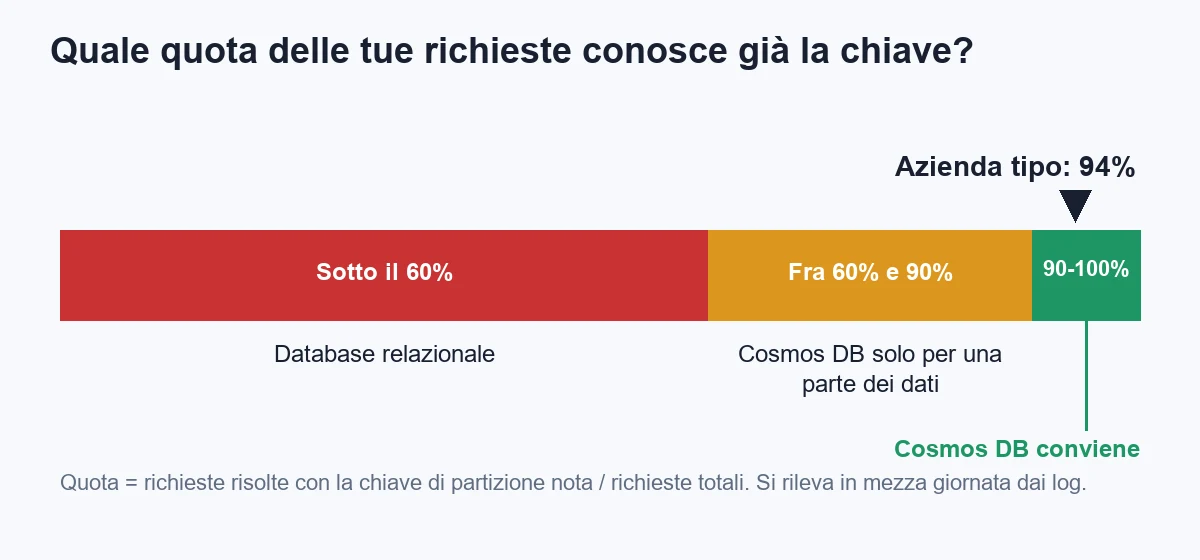
Il numero che decide non è il volume dei dati e non è il numero di utenti. È la quota di richieste che il tuo software risolve conoscendo già la chiave.
Spiego con un esempio. Quando il portale clienti mostra lo stato dell'impianto 417, la richiesta contiene già tutto quello che serve: il cliente e l'impianto. Il database va a prendere quel documento e basta. Questa è una lettura per chiave, e in Cosmos DB costa circa 1 RU per ogni kilobyte letto, cioè quasi niente.
Quando invece un responsabile chiede "tutti gli interventi non conclusi del mese, per tecnico, con il margine", la richiesta non ha una chiave: deve guardare dappertutto. Questa è una query fra partizioni, e costa molto di più, perché il database la deve far girare su ogni partizione.
La regola che uso è questa:
- Sopra il 90 per cento di richieste con chiave nota: Cosmos DB è una scelta sensata.
- Fra il 60 e il 90 per cento: usalo solo per la parte di dati che ha questo profilo (gli eventi, la sessione, il catalogo) e tieni il resto su un database relazionale.
- Sotto il 60 per cento: scegli un database relazionale. Con Cosmos DB passeresti il tempo a combattere il modello.
Nell'azienda tipo il conto è semplice. Ogni giorno ci sono circa 400.000 letture per chiave (stato impianto, ultimi eventi, scheda intervento) e circa 30.000 query di ricerca e di report. La quota è 400.000 diviso 430.000, cioè 93 per cento, che arrotondo al 94 per cento contando anche le scritture, che hanno sempre la chiave.
Il secondo controllo è la forma dei dati. Cosmos DB rende bene quando il documento è "autonomo": l'intervento porta con sé checklist e materiali, e li leggi sempre insieme. Rende male quando hai molte relazioni fra entità che si leggono in combinazioni sempre diverse (clienti, ordini, listini, sconti, agenti). Lì il join è il tuo amico, e Cosmos DB non lo ha davvero.
Il terzo controllo è chi sa mantenerlo. Un database a unità di richiesta si "legge" in un modo diverso: bisogna guardare quante RU costa ogni operazione, accorgersi di una query che da 3 passa a 300, sistemare la chiave. Se in azienda non c'è nessuno che ci pensi, il rischio è la fattura che sale in silenzio.
Se i tre controlli dicono sì, il resto dell'articolo ti serve. Se dicono no, hai già risparmiato un progetto.
Com'è fatta l'azienda tipo e da quali numeri parte?
L'azienda tipo fa manutenzione di impianti di climatizzazione per condomini e piccole industrie. Ha 60 persone, 38 delle quali sono tecnici con un tablet. Ha in gestione 900 impianti, ognuno con un sensore che manda una lettura ogni 30 minuti. Ha un portale dove i clienti vedono stato e storico.
Oggi tutto sta in un gestionale su SQL Server di undici anni, che regge a fatica: le letture dei sensori hanno riempito una tabella da 190 milioni di righe e il portale rallenta ogni volta che parte un report. Il team valuta Cosmos DB per la parte "eventi e stato impianti".
Ecco i numeri, quelli che rilevi in mezza giornata con le statistiche del database e i log delle richieste.
| Misura | Valore | Come si rileva |
|---|---|---|
| Scritture al giorno | circa 43.000 (42.000 eventi dei sensori, 1.000 aggiornamenti di interventi) | 900 sensori per 48 letture al giorno, più il registro interventi |
| Dimensione di un documento | circa 2 KB | Media sui documenti campione |
| Letture per chiave al giorno | circa 400.000 | Log del portale e dell'app tecnici |
| Query di ricerca e report al giorno | circa 30.000 | Registro delle query |
| Quota di richieste con chiave nota | circa 94 per cento | Il numero che decide |
| Dati conservati | 32 GB a regime (eventi tenuti 12 mesi) | Dimensione attuale più la regola di scadenza |
| Costo di una giornata di sviluppo | 480 euro | Tariffa di riferimento |
Due note sui numeri. La prima: i 190 milioni di righe sono il vero problema di oggi, ma sono anche un'occasione, perché gli eventi dei sensori sono il caso perfetto per Cosmos DB. Si scrivono una volta, si leggono per impianto, scadono dopo un anno.
La seconda: non tutto va spostato. Anagrafiche, contratti, fatture e listini restano su SQL, dove i join e le transazioni sono di casa. L'errore tipico è decidere che "il database nuovo" sostituisce quello vecchio. Quasi mai è così.
Come si paga Cosmos DB: che cosa sono le unità di richiesta?
Ogni operazione costa un certo numero di unità di richiesta, o RU. È una valuta interna che mescola processore, memoria e disco. Non devi capire come si calcola: devi sapere gli ordini di grandezza.
- Leggere per chiave un documento da 1 KB: 1 RU. Da 2 KB: circa 2 RU.
- Scrivere un documento da 1 KB con l'indicizzazione di default: circa 5 RU. Da 2 KB: circa 10.
- Una query su una sola partizione, con filtro su campi indicizzati e pochi risultati: da 3 a 30 RU.
- Una query che attraversa tutte le partizioni, con molti risultati: centinaia o migliaia di RU.
Il punto da fissare è che il costo dipende da come chiedi, non da quanti dati hai. Una lettura per chiave costa 1 RU anche con un miliardo di documenti. Una query mal fatta può costare 2.000 RU anche con un milione.
Ogni risposta dell'SDK ti dice quanto è costata. È la prima abitudine da prendere: guardare quel numero in fase di sviluppo, come si guarda il piano di esecuzione in SQL.
Quando il carico supera la capacità acquistata, Cosmos DB risponde con l'errore 429, "troppe richieste", e il tempo da attendere. L'SDK ritenta da solo, ma se l'ondata è lunga le richieste falliscono. Non è un guasto: è il database che ti dice che hai comprato troppo poco.
Il conto della spesa ha due voci. Le RU (a consumo o prenotate) e lo spazio occupato, che costa pochi centesimi per GB al mese. Per l'azienda tipo lo spazio vale circa 7 euro al mese a 32 GB. Il resto dipende da come compri le RU.
Quanto costa Cosmos DB nei tre modi di pagare?
Per comprare capacità ci sono tre strade, più una scorciatoia. I prezzi sono ordini di grandezza a una regione europea, quelli che avevo sotto mano al momento di scrivere. Prima di decidere, rifai il conto con il calcolatore di Azure.
| Modo | Come funziona | Prezzo indicativo | Quando conviene |
|---|---|---|---|
| Serverless | Paghi solo le RU consumate | circa 0,23 euro ogni milione di RU | Carico basso o a picchi, sviluppo, applicazioni nuove |
| Throughput prenotato (manuale) | Compri una quota fissa di RU al secondo | circa 5,40 euro al mese ogni 100 RU/s | Carico stabile e prevedibile |
| Autoscale | Scegli un massimo, il database scala fra il 10 e il 100 per cento | circa 8,10 euro al mese ogni 100 RU/s di massimo, ma pagando solo quello usato | Carico variabile nella giornata |
| Livello gratuito | I primi 1.000 RU/s e 25 GB senza costo, un solo account per abbonamento | 0 euro fino al limite | Primo progetto di un abbonamento Azure |
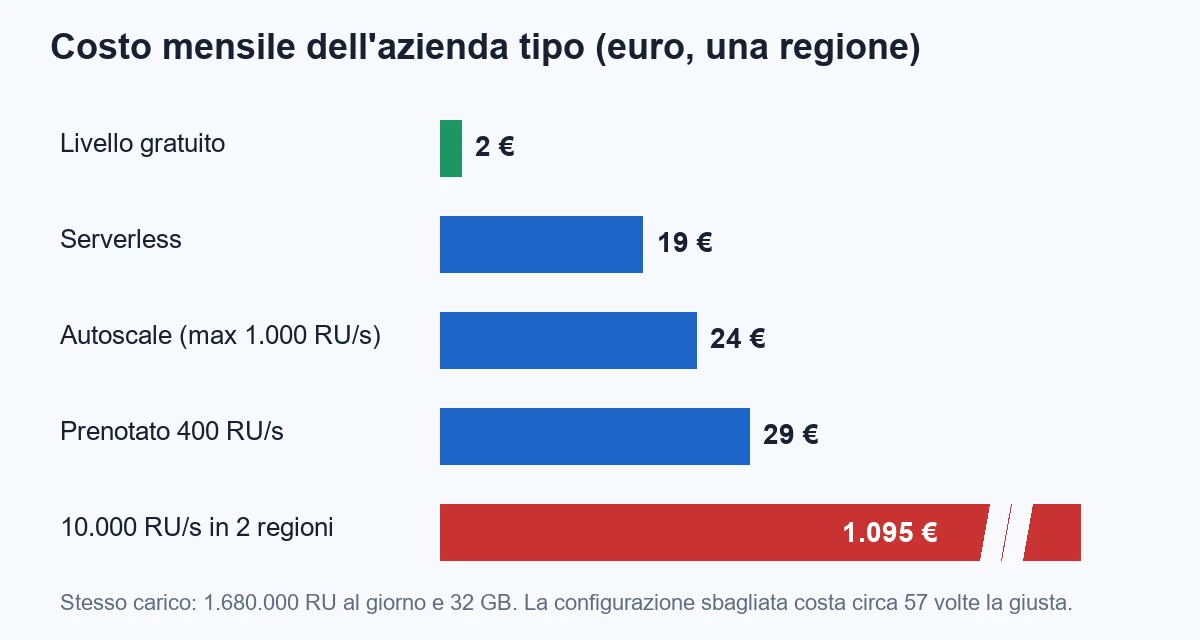
Il conto per l'azienda tipo, passo per passo. Le RU al giorno sono: 43.000 scritture a 10 RU fanno 430.000; 400.000 letture a 2 RU fanno 800.000; 30.000 query a 15 RU fanno 450.000. Il totale è 1.680.000 RU al giorno, cioè circa 50 milioni al mese.
Ora le quattro strade.
- Serverless: 50 milioni di RU a 0,23 euro per milione fanno 11,60 euro, più 7,40 euro di spazio. Totale circa 19 euro al mese.
- Throughput prenotato: il minimo sensato è 400 RU/s, cioè 21,60 euro, più 7,40 di spazio. Totale circa 29 euro al mese. Paghi anche di notte, quando non c'è nessuno.
- Autoscale con massimo a 1.000 RU/s: di notte sta al 10 per cento, di giorno sale. Con una media di 200 RU/s pagati, circa 16 euro più 7,40 di spazio. Totale circa 24 euro al mese.
- Livello gratuito: 400 RU/s prenotati rientrano tutti nei 1.000 gratuiti. Dei 32 GB, 25 sono inclusi e 7 si pagano, circa 1,60 euro. Totale circa 2 euro al mese.
Ora il caso della proposta di apertura. Dieci mila RU/s prenotati fanno 100 per 5,40, cioè 540 euro al mese. Replicati in due regioni raddoppiano: 1.080 euro. Con lo spazio duplicato si arriva a circa 1.095 euro al mese, cioè 13.140 euro l'anno per un carico che ne richiedeva 228.
La proporzione è di circa 57 a 1. Non è un errore del fornitore: nessuno ha sbagliato un calcolo, hanno messo il margine di sicurezza dove costa di più. Il margine in Cosmos DB si compra in RU, e le RU si pagano ogni ora.
Tre avvertenze sul conto.
- Il serverless ha un tetto di picco per container (qualche migliaio di RU/s): per un carico che sale di dieci volte conviene passare al prenotato o all'autoscale.
- Il livello gratuito non si combina con il serverless e vale per un solo account per abbonamento. Se il tuo abbonamento ne ha già uno, non lo avrai.
- Backup, traffico in uscita dalla regione e funzioni extra (per esempio la scrittura in più regioni) hanno costi a parte, che per l'azienda tipo valgono pochi euro ma in altri casi no.
Come si sceglie la chiave di partizione, l'unica decisione che non si corregge?
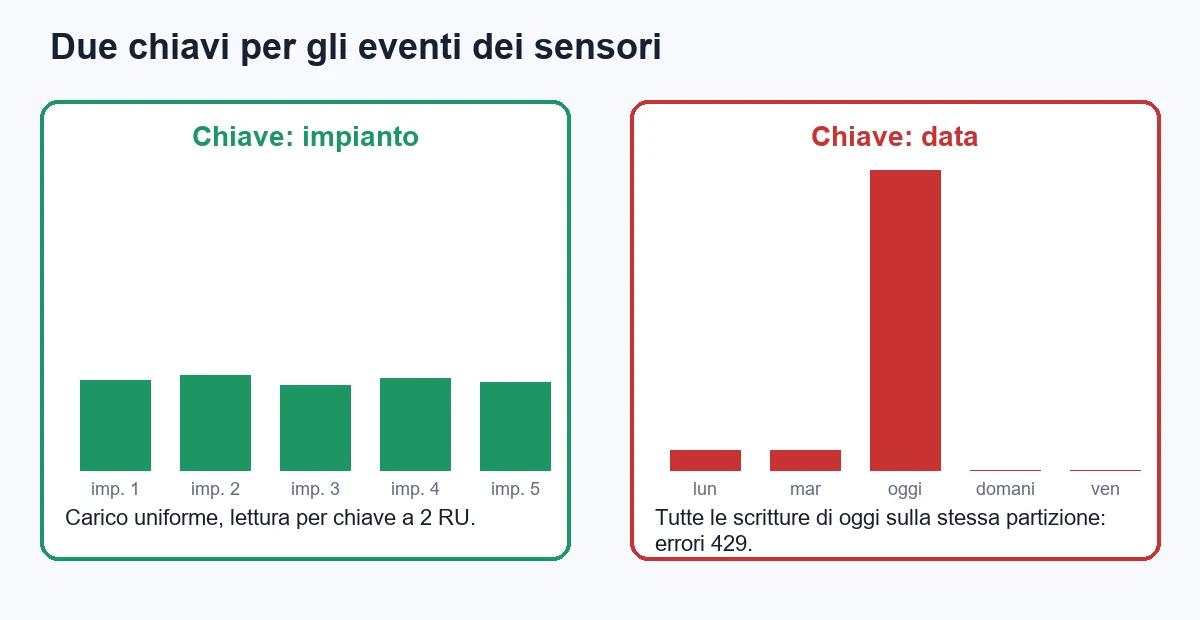
Quando crei un contenitore (l'equivalente di una tabella) devi indicare la chiave di partizione: un campo del documento, per esempio /impiantoId. Cosmos DB raggruppa tutti i documenti con lo stesso valore in una partizione logica e le distribuisce sulle macchine.
Questa scelta decide tre cose: quanto costano le query, quanto si distribuisce bene il carico e quanto in alto puoi arrivare. E non si cambia: per usarne un'altra devi creare un nuovo contenitore e copiare tutto.
I vincoli da conoscere sono pochi.
- Una partizione logica può contenere fino a 20 GB. Se una chiave raccoglie più dati, hai un problema senza soluzione.
- Ogni partizione fisica regge circa 10.000 RU/s. Se tutto il traffico cade su una chiave, il resto della capacità comprata non serve a niente.
- Il documento può pesare al massimo 2 MB. Non è un posto per i file: i PDF e le foto vanno su un archivio di blob, e nel documento metti il riferimento.
Una buona chiave ha tre qualità: tanti valori diversi (alta cardinalità), carico distribuito in modo uniforme e presente nella maggior parte delle richieste.
Per gli eventi dei sensori ci sono due candidate. La data sembra naturale, perché i report sono per periodo. Ma tutte le scritture di oggi cadono sullo stesso valore: una partizione sola riceve 42.000 scritture e le altre dormono. È il difetto che si chiama partizione calda, e si manifesta con una pioggia di 429 mentre il database "ha capacità libera".
L'identificativo dell'impianto è la scelta giusta. Sono 900 valori, ognuno riceve 48 scritture al giorno, ogni partizione logica occupa circa 35 MB all'anno, quasi niente rispetto al limite. E il portale, quando mostra l'impianto 417, ha già la chiave.
La trappola è che con 32 GB l'errore non si vede. Alla tua scala c'è una sola partizione fisica, quindi anche una chiave sbagliata funziona e le query fra partizioni costano poco. Il conto arriva quando i dati crescono dieci volte e le stesse query toccano dieci partizioni.
Per questo, la prova da fare prima di cominciare è sulla pagina del tuo prodotto più importante: scrivi le dieci richieste più frequenti e per ognuna segna quale campo conosci già. Se non c'è un campo comune alla maggioranza, hai un segnale che il modello non è adatto.
Per i casi in cui una chiave sola non basta, esistono le chiavi gerarchiche: fino a tre livelli, per esempio cliente e poi impianto. Servono quando un cliente solo potrebbe superare i 20 GB, o per dividere meglio il carico di un'applicazione multi-cliente.
Come si modella un documento: incorporare o riferire?
In SQL normalizzi: ogni informazione sta in un posto solo e la ricomponi con i join. In Cosmos DB ragioni al contrario: un documento contiene quello che leggi insieme.
Il criterio che uso è semplice. Incorpora (dentro lo stesso documento) quando le parti hanno la stessa vita, si leggono insieme e sono in numero limitato. Riferisci (con un identificativo) quando le parti hanno vita propria, crescono senza limite o cambiano spesso.
Un intervento è un buon documento da incorporare: la checklist, i materiali usati e le note nascono e muoiono con lui. I dati anagrafici del cliente invece si riferiscono, perché cambiano nel tempo e li usano mille altri documenti.
Ecco il documento dell'intervento come lo modellerei, con la chiave scelta sopra.
public sealed class Intervento
{
    public string Id { get; set; } = Guid.NewGuid().ToString("N");
    public string ClienteId { get; set; } = "";     // chiave di partizione
    public string ImpiantoId { get; set; } = "";
    public string Tecnico { get; set; } = "";
    public string Stato { get; set; } = "aperto";
    public DateTime Data { get; set; }
    public decimal Importo { get; set; }
    public List<VoceChecklist> Checklist { get; set; } = new();
    public List<MaterialeUsato> Materiali { get; set; } = new();
}

public sealed class VoceChecklist
{
    public string Descrizione { get; set; } = "";
    public bool Esito { get; set; }
}

public sealed class MaterialeUsato
{
    public string Codice { get; set; } = "";
    public decimal Quantita { get; set; }
}
Noterai che le foto non ci sono: stanno su un archivio di blob, e il documento porta solo l'indirizzo. Un documento che cresce senza controllo (note infinite, storico di ogni modifica) è il secondo errore classico dopo la chiave sbagliata.
Un'altra regola: niente join fra contenitori. Non esistono. Se hai bisogno del nome del cliente nell'elenco, lo copi dentro il documento al momento della scrittura. Sì, è una duplicazione, e sì, se il cliente cambia nome devi decidere se aggiornare gli interventi vecchi. Di solito la risposta è no: l'intervento di tre anni fa porta il nome che aveva allora, ed è anche la cosa giusta dal punto di vista legale.
Come si scrive il codice C# per Cosmos DB senza farsi male?
Quattro regole valgono più di qualsiasi libreria.
- Un solo client per tutta l'applicazione.
CosmosClientè pensato per vivere quanto il processo. Crearne uno per richiesta svuota le connessioni e fa salire latenza e costi. - Credenziali dell'identità, non chiavi. Con
DefaultAzureCredentiall'applicazione si autentica con la sua identità gestita e nel codice non c'è nessun segreto da proteggere. - Letture per chiave ovunque sia possibile.
ReadItemAsynccosta circa 1 RU per KB, una query con lo stesso risultato ne costa il triplo. - Guardare le RU in sviluppo. Ogni risposta ha
RequestCharge: scrivilo nel log delle prove.
Prima la registrazione del client, in Program.cs.
using Azure.Identity;
using Microsoft.Azure.Cosmos;

builder.Services.AddSingleton(sp =>
{
    var cfg = sp.GetRequiredService<IConfiguration>();

    return new CosmosClient(
        cfg["Cosmos:Endpoint"],
        new DefaultAzureCredential(),
        new CosmosClientOptions
        {
            ConnectionMode = ConnectionMode.Direct,
            SerializerOptions = new CosmosSerializationOptions
            {
                PropertyNamingPolicy = CosmosPropertyNamingPolicy.CamelCase
            },
            MaxRetryAttemptsOnRateLimitedRequests = 5,
            MaxRetryWaitTimeOnRateLimitedRequests = TimeSpan.FromSeconds(10)
        });
});

builder.Services.AddSingleton<InterventiRepository>();
La politica dei nomi in camelCase serve perché Cosmos DB vuole il campo id minuscolo. Con questa impostazione la proprietà Id viene scritta nel modo giusto.
Poi il repository con le quattro operazioni che servono davvero: leggere per chiave, creare, aggiornare con controllo di concorrenza e cercare gli interventi aperti di un tecnico.
using System.Net;
using Microsoft.Azure.Cosmos;

public sealed class InterventiRepository(CosmosClient client, ILogger<InterventiRepository> log)
{
    private readonly Container _c = client.GetContainer("manutenzione", "interventi");

    public async Task<Intervento?> LeggiAsync(string clienteId, string id, CancellationToken ct)
    {
        try
        {
            var r = await _c.ReadItemAsync<Intervento>(id, new PartitionKey(clienteId), cancellationToken: ct);
            log.LogDebug("Lettura {Id}: {Ru} RU", id, r.RequestCharge);
            return r.Resource;
        }
        catch (CosmosException ex) when (ex.StatusCode == HttpStatusCode.NotFound)
        {
            return null;
        }
    }

    public async Task CreaAsync(Intervento i, CancellationToken ct)
    {
        var r = await _c.CreateItemAsync(i, new PartitionKey(i.ClienteId), cancellationToken: ct);
        log.LogDebug("Creazione {Id}: {Ru} RU", i.Id, r.RequestCharge);
    }

    public async Task<bool> AggiornaAsync(Intervento i, string etag, CancellationToken ct)
    {
        try
        {
            await _c.ReplaceItemAsync(i, i.Id, new PartitionKey(i.ClienteId),
                new ItemRequestOptions { IfMatchEtag = etag }, ct);
            return true;
        }
        catch (CosmosException ex) when (ex.StatusCode == HttpStatusCode.PreconditionFailed)
        {
            return false; // qualcun altro ha modificato nel frattempo
        }
    }

    public async Task<List<Intervento>> AperteDelTecnicoAsync(string clienteId, string tecnico, CancellationToken ct)
    {
        var query = new QueryDefinition(
                "SELECT c.id, c.clienteId, c.impiantoId, c.data, c.stato, c.importo " +
                "FROM c WHERE c.tecnico = @tecnico AND c.stato = 'aperto' ORDER BY c.data DESC")
            .WithParameter("@tecnico", tecnico);

        var opzioni = new QueryRequestOptions
        {
            PartitionKey = new PartitionKey(clienteId),
            MaxItemCount = 50
        };

        var risultati = new List<Intervento>();
        double ru = 0;

        using var it = _c.GetItemQueryIterator<Intervento>(query, requestOptions: opzioni);
        while (it.HasMoreResults)
        {
            var pagina = await it.ReadNextAsync(ct);
            ru += pagina.RequestCharge;
            risultati.AddRange(pagina);
        }

        log.LogDebug("Interventi aperti di {Tecnico}: {N} risultati, {Ru} RU", tecnico, risultati.Count, ru);
        return risultati;
    }
}
Tre dettagli che fanno risparmiare soldi.
- La query elenca le colonne. Non c'è
SELECT *: restituire solo i campi che servono riduce la risposta e, in certi casi, anche le RU. È la stessa disciplina che serve in SQL. - La chiave di partizione è nelle opzioni. Senza
PartitionKeyla query viene eseguita su tutte le partizioni. Con il filtro nella clausola ma non nelle opzioni, a volte il database lo capisce da solo, a volte no: non scommettere. - L'ETag evita di sovrascrivere. Due tecnici che modificano lo stesso intervento: il secondo riceve un errore 412 e può rileggere. Senza, l'ultimo scrive e il lavoro del primo sparisce.
Per creare il tutto da riga di comando con il livello gratuito (un solo account per abbonamento), bastano tre comandi.
az cosmosdb create -n cosmos-manutenzione -g rg-manutenzione \
  --enable-free-tier true --default-consistency-level Session \
  --locations regionName=westeurope failoverPriority=0

az cosmosdb sql database create -a cosmos-manutenzione -g rg-manutenzione \
  -n manutenzione --throughput 400

az cosmosdb sql container create -a cosmos-manutenzione -g rg-manutenzione \
  -d manutenzione -n interventi -p /clienteId
Per lo sviluppo in locale non serve un account Azure: Microsoft offre un emulatore che gira in un contenitore. Provi il codice, guardi le RU e non spendi niente.
Un cenno su Entity Framework. Il provider per Cosmos DB funziona e per un team abituato a EF è un buon punto di partenza. Ma nasconde proprio l'informazione che ti serve, cioè quanto costa ogni operazione, e le query generate possono attraversare tutte le partizioni senza avvisarti. Lo uso per piccole applicazioni; dove il costo conta, preferisco l'SDK diretto.
Quale livello di consistenza scegliere fra i cinque disponibili?
Quando i dati sono copiati in più posti, bisogna decidere quanto è "fresca" una lettura. Cosmos DB offre cinque livelli, dal più rigido al più veloce.
| Livello | Che cosa garantisce | Quando lo uso |
|---|---|---|
| Forte | Leggi sempre l'ultima scrittura, in qualunque regione | Quasi mai: costa latenza e non lo trovi in tutte le configurazioni |
| Obsolescenza limitata | Il ritardo massimo ha un limite che scegli | Dati finanziari replicati su più regioni |
| Sessione (predefinito) | Chi scrive legge sempre quello che ha scritto | La scelta giusta per il 90 per cento delle applicazioni |
| Prefisso coerente | Gli aggiornamenti arrivano in ordine, mai fuori sequenza | Flussi di eventi da leggere in ordine |
| Eventuale | Prima o poi i dati convergono, senza garanzie sull'ordine | Contatori, "mi piace", dati non critici |
Il livello sessione è quello predefinito per una ragione: il tecnico che chiude un intervento e ricarica la scheda deve vedere la chiusura, ma non gli interessa se un collega in un'altra regione la vede dopo mezzo secondo. Copre quasi tutti i casi, costa come gli altri e non richiede riflessioni.
Il livello forte ha un prezzo nascosto: ogni scrittura deve essere confermata dalle altre regioni prima di rispondere, e nelle letture si paga il doppio delle RU. Se lo pensi per "essere sicuro", prima chiediti quale errore concreto stai evitando.
La regola: parti da sessione. Cambia solo se un caso concreto lo richiede, e scrivi nel progetto quale.
Serve davvero la replica in più regioni?
È la funzione più pubblicizzata e quella che più spesso si compra senza bisogno. Prima di aggiungere una regione, le domande sono tre.
- I tuoi utenti sono davvero in più continenti? L'azienda tipo lavora in Lombardia e Veneto. Una regione europea serve tutti con latenze di 10-20 millisecondi. Una seconda regione a Singapore non cambierebbe nulla per nessuno.
- Quanto costa un'ora di fermo? Una regione sola ha una disponibilità dichiarata del 99,99 per cento, circa 52 minuti di fermo l'anno. Con più regioni sale al 99,999 per cento, circa 5 minuti. Per una app di manutenzione, la differenza vale qualche centinaio di euro l'anno. Il raddoppio del conto ne vale ottomila.
- Hai un obbligo di legge sulla posizione dei dati? Con i dati personali di cittadini europei, replicare fuori dall'Unione apre un problema di conformità che il risparmio di latenza non ripaga.
Ogni regione aggiunta moltiplica il costo delle RU e dello spazio. Con una regione sola, per l'azienda tipo, la spesa è 19 euro. Con due sono circa 38, e se attivi la scrittura in più regioni il prezzo delle RU sale di un ulteriore 25 per cento circa.
La mia posizione è questa: parti con una regione, attiva le zone di disponibilità se il prezzo extra è accettabile (proteggono dal guasto di un centro dati senza il costo di una seconda regione) e aggiungi regioni solo quando un numero lo giustifica.
Come si protegge Cosmos DB senza complicarsi la vita?
Un database aperto su Internet con una chiave in un file di configurazione è, purtroppo, la configurazione più comune che incontro. Le protezioni utili sono quattro e si fanno in un pomeriggio.
- Disattiva le chiavi di accesso. Cosmos DB supporta il controllo degli accessi con Microsoft Entra ID: l'applicazione usa la sua identità gestita e tu puoi spegnere l'autenticazione a chiave. Se una chiave non esiste, non può uscire in un repository.
- Dai il minimo privilegio. Il ruolo di lettura per chi legge, quello di scrittura per chi scrive. Il portale clienti non ha bisogno di cancellare.
- Chiudi la rete. Limita l'accesso agli indirizzi o alla rete virtuale dell'applicazione. Un database gestito non ha motivo di rispondere al resto di Internet.
- Non salvare dati che non ti servono. Un documento con codice fiscale, telefono e indirizzo che nessuna schermata usa è un rischio senza ritorno. Le regole di scadenza (TTL) cancellano da sole quello che ha esaurito il suo scopo.
La regola di scadenza è anche una leva di costo, e per i sensori è la più importante: con una scadenza di 12 mesi sul contenitore degli eventi, i documenti più vecchi spariscono e lo spazio smette di crescere. Senza, a due anni avresti 64 GB e il doppio dello spazio da pagare.
Il TTL si imposta sul contenitore (un valore in secondi) e funziona senza consumare RU di cancellazione che paghi tu: il database usa la capacità libera. Una riga di configurazione che vale più di un'ottimizzazione di codice.
Come si tiene sotto controllo la spesa nel tempo?
Il pericolo di Cosmos DB non è il prezzo di partenza. È la deriva: una query nuova che costa dieci volte, un campo aggiunto che fa crescere l'indice, un report del lunedì che attraversa tutte le partizioni. A fine mese la fattura è diversa e nessuno sa perché.
Cinque abitudini che prevengono quasi tutto.
- Un avviso di spesa. Imposta un budget con soglia al 50, 80 e 100 per cento. Costa zero e ti avvisa prima che sia tardi.
- Un grafico sulle RU consumate. Le metriche di Azure Monitor mostrano le RU per contenitore e per partizione. Guarda la partizione più carica: se è il triplo delle altre, hai una chiave sbilanciata.
- Il tasso di 429. Un po' di 429 che l'SDK ritenta senza che nessuno se ne accorga sono normali. Una quota crescente dice che hai comprato poco o che c'è una partizione calda.
- La politica di indicizzazione. Di default Cosmos DB indicizza ogni campo di ogni documento, ed è il motivo per cui una scrittura da 2 KB costa 10 RU. Se sai quali campi filtri, escludi gli altri e dimezzi il costo delle scritture. Per i sensori, dove filtri solo per impianto e data, è un risparmio concreto.
- Una revisione trimestrale. Ogni tre mesi si guarda la spesa, le dieci operazioni più costose e il tipo di capacità acquistata. Il serverless che oggi conviene può smettere di convenire quando il carico si stabilizza.
Un esempio dell'indicizzazione. Con l'indice su tutti i campi, la scrittura dell'evento costa circa 10 RU. Indicizzando solo impiantoId e data, scende a circa 6. Le 42.000 scritture al giorno passano da 420.000 a 252.000 RU. Sono 5 milioni di RU in meno al mese, cioè circa 1,15 euro. Sembra poco, ma è un'ora di lavoro per un risparmio che si ripete ogni mese e cresce con il volume.
Cosmos DB, Azure SQL, PostgreSQL: quale scegliere per l'azienda tipo?
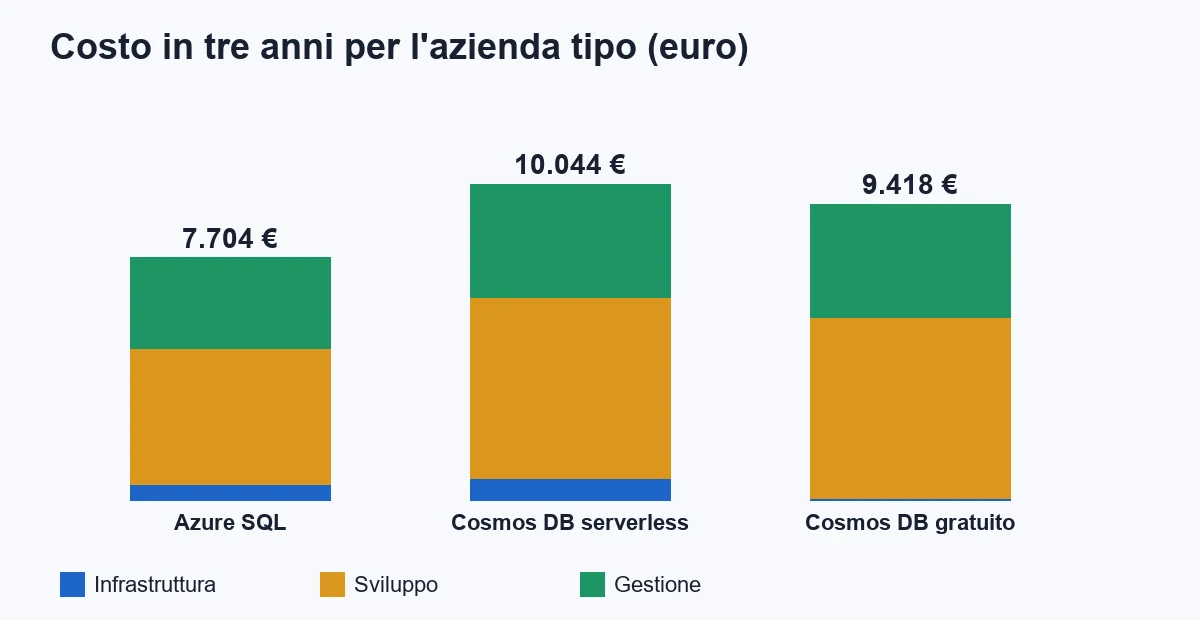
Il confronto onesto parte da una domanda: per questo carico, quanto costa davvero ciascuna strada in tre anni, contando anche il lavoro?
Ipotesi di partenza: la parte "eventi e stato impianti" è nuova, e ognuna delle tre strade la copre. Il lavoro è a 480 euro a giornata. Le stime di giornate sono quelle di un team che conosce lo strumento.
| Voce | Azure SQL (S0, circa 14 euro al mese) | Cosmos DB serverless (circa 19 euro al mese) | Cosmos DB livello gratuito (circa 2 euro al mese) |
|---|---|---|---|
| Infrastruttura in 3 anni | 504 euro | 684 euro | 58 euro |
| Sviluppo iniziale | 9 giornate, 4.320 euro | 12 giornate, 5.760 euro | 12 giornate, 5.760 euro |
| Gestione (giornate in 3 anni) | 6 giornate, 2.880 euro | 7,5 giornate, 3.600 euro | 7,5 giornate, 3.600 euro |
| Totale in 3 anni | circa 7.700 euro | circa 10.000 euro | circa 9.400 euro |
Il risultato va detto chiaramente: per questo carico, a questa scala, Azure SQL costa meno. Circa 2.300 euro in tre anni, perché il team lo conosce già e perché Cosmos DB richiede più lavoro di modellazione.
E allora perché ho scelto questo esempio? Perché il conto vero non si fa solo oggi. Ci sono tre cose che il confronto in tabella non mostra.
- La crescita. Con 900 sensori che diventano 9.000, il carico decuplica. Su Cosmos DB le RU crescono in modo lineare e non c'è nessuna migrazione da fare. Su SQL si passa a un livello di prezzo molto più alto, o si comincia a dividere le tabelle a mano.
- La forma dei dati. Se i sensori diventano di tre tipi, poi di dieci, ognuno con campi propri, in SQL ogni tipo è una modifica dello schema, in Cosmos DB è un campo in più nel documento.
- Il carico irregolare. Se i sensori mandano dati a raffiche (dopo un guasto di rete arrivano in una volta sola le letture di tre ore), un database prenotato va in difficoltà e Cosmos DB in serverless o con autoscale assorbe.
Se nessuna di queste tre cose è nel tuo futuro prevedibile, la scelta migliore è il database che il team conosce. È una risposta noiosa, e spesso è quella giusta.
Un'ultima alternativa che vale una riga: PostgreSQL con colonne JSON copre bene molti casi da "documento", costa come un database relazionale e si interroga con SQL. Per chi ha dati misti (parte relazionali, parte a documento) è spesso il compromesso migliore, e non va escluso solo perché "non è NoSQL".
Quali errori evitare quando si adotta Cosmos DB?
Gli errori che vedo più spesso, e che costano di più, sono otto.
- Usarlo come se fosse SQL. Documenti piccoli, uno per tabella, collegati da identificativi e riuniti con più chiamate. Perdi la velocità e raddoppi il costo.
- Scegliere la chiave per i report. La chiave si sceglie per le richieste che fai più spesso, non per quella del lunedì mattina. Il report si risolve in un altro modo.
- Prenotare per paura. Dieci mila RU/s "per stare tranquilli" sono 540 euro al mese. Parti con il serverless o con l'autoscale, misura per un mese, poi decidi.
- Ignorare i 429. Ritentati in silenzio, mascherano un'applicazione che è al limite. Fino al giorno in cui il limite viene superato per un'ora intera.
- Creare un client per ogni richiesta. Lo vedo in un'applicazione su due. Il client è pesante da creare e va riutilizzato.
- Documenti che crescono senza limite. Un array che raccoglie ogni modifica per anni prima o poi arriva a 2 MB. Metti un tetto, o spostalo in un contenitore separato.
- Replicare in più regioni "perché c'è". Il raddoppio del conto è garantito, il beneficio spesso no.
- Non avere un piano per ricaricare i dati. Un contenitore con la chiave sbagliata si ricrea e si ricopia. Se non hai provato la procedura prima, la proverai nel momento peggiore.
Una regola le riassume tutte: in Cosmos DB ogni scelta di modello ha un prezzo mensile. A differenza di un server, dove una cattiva idea ti costa tempo, qui ti costa soldi ogni ora che resta in produzione. Per questo è un database che premia chi misura.
Come lo provi in sessanta giorni, senza rischi?
Non serve decidere subito. Si può provare Cosmos DB su una parte del sistema, a costo quasi zero, e fermarsi se i numeri non tornano. Il piano che propongo:
- Giorni 1-5: i numeri. Compila la tabella dell'azienda tipo con i tuoi dati. Il risultato è la quota di richieste con chiave nota e il conto delle RU al giorno. Se la quota è sotto il 60 per cento, fermati qui e hai risparmiato.
- Giorni 6-10: il perimetro. Scegli una sola area con il profilo giusto: eventi, sessioni, catalogo, notifiche. Mai l'anagrafica clienti o la contabilità.
- Giorni 11-15: chiave e modello. Scrivi le dieci richieste più frequenti, scegli la chiave, disegna i documenti. Falla rivedere a una seconda persona: è la decisione che non si corregge.
- Giorni 16-30: il prototipo sull'emulatore. Codice come quello sopra, dati di prova, log delle RU. Obiettivo: ogni operazione frequente sotto le 10 RU.
- Giorni 31-40: l'account vero, serverless o gratuito. Carica un mese di dati reali. Controlla spesa, 429 e partizioni.
- Giorni 41-55: doppia scrittura. Per due settimane l'applicazione scrive su tutti e due i database e legge dal vecchio. Un confronto automatico segnala le differenze. Se qualcosa non torna, lo scopri prima dei clienti.
- Giorni 56-60: la decisione. Sposta le letture su Cosmos DB per il 10 per cento degli utenti, poi per tutti, oppure spegni il prototipo. In entrambi i casi hai dati veri e non opinioni.
Il costo di questa prova, per l'azienda tipo, è di 12 giornate di lavoro, cioè 5.760 euro, più un'infrastruttura che nei due mesi vale meno di 5 euro. Se la risposta è no, hai speso il prezzo di un preventivo sbagliato e l'hai scoperto in due mesi invece che in due anni.
Alla fine del periodo conviene anche decidere i limiti di sicurezza: un tetto di budget, un responsabile della revisione trimestrale e un piano per tornare indietro. Il passo indietro costa poco finché il vecchio database è ancora acceso e aggiornato: spegnerlo troppo presto è l'errore che rende irreversibile una prova.
E se il numero dice che Cosmos DB non è il tuo problema?
Succede spesso, ed è una buona notizia. Se meno del 60 per cento delle tue richieste conosce la chiave, se i dati sono pieni di relazioni, se il carico è quello di un gestionale con qualche centinaio di utenti, Cosmos DB non ti serve. Un database relazionale ben tenuto costa meno e il tuo team lo conosce.
Se il problema è una tabella da 190 milioni di righe che rallenta tutto, controlla prima gli indici, il partizionamento della tabella e l'archiviazione dei dati vecchi. Spesso un fine settimana di lavoro sposta il problema di tre anni, a una frazione del costo.
Se il costo del cloud è il tuo problema, il discorso è un altro e si risolve prima con le basi: scalare a zero quello che non serve, accorpare i database piccoli in uno solo, chiudere le risorse dimenticate. Ne parlo in come risparmiare con Azure e, per una PMI, in Azure per le PMI italiane: ridurre i costi e scalare senza un team cloud.
Se sei arrivato fin qui, probabilmente hai in mente un preventivo con più zeri del necessario. Prima di firmare, prendi i tuoi numeri: scritture e letture al giorno, dimensione dei documenti, quota di richieste con chiave nota, regioni davvero necessarie. Mezza giornata di lavoro, e sai se parli di 19 euro o di 1.095.
Se vuoi un secondo sguardo sul tuo caso, la strada è la consulenza software. E quando la soluzione giusta è un gestionale costruito attorno al tuo modo di lavorare, con una base dati scelta per i tuoi numeri e non per la moda del momento, lo trovi spiegato nella pagina sul software su misura.
Domande frequenti
È un database gestito da Microsoft che salva documenti JSON e li distribuisce in partizioni in base a una chiave scelta da te. Si paga a unità di richiesta (RU), cioè in base alle operazioni eseguite, e può replicare i dati in più regioni. Non è un SQL Server più veloce: è fatto per un altro tipo di accesso, quello per chiave.
Dipende dal modo di pagare. Per un carico di 1,7 milioni di RU al giorno e 32 GB, ordini di grandezza: circa 2 euro al mese con il livello gratuito, 19 in serverless, 24 in autoscale, 29 con throughput prenotato di 400 RU/s. La stessa applicazione con 10.000 RU/s in due regioni costa circa 1.095 euro al mese.
Quando oltre il 90 per cento delle richieste conosce già la chiave di partizione, i documenti sono autonomi e il carico cresce o è irregolare. Sotto il 60 per cento di richieste con chiave nota, o con molte relazioni fra entità, un database relazionale costa meno e il team lo conosce già.
È il campo del documento che Cosmos DB usa per distribuire i dati sulle macchine. Decide quanto costano le query e quanto si bilancia il carico, e non si cambia dopo: per usarne un'altra bisogna creare un nuovo contenitore e ricopiare tutto. Una chiave sbagliata, come la data, concentra il traffico su una partizione sola.
Parti dal livello sessione, che è quello predefinito: chi scrive legge sempre ciò che ha scritto e il costo è lo stesso degli altri. Il livello forte raddoppia le RU in lettura e aumenta la latenza. Cambia solo se un caso concreto lo richiede.
Raramente. Una regione europea serve bene utenti italiani con 10-20 millisecondi di latenza e ha una disponibilità dichiarata del 99,99 per cento. Ogni regione aggiunta moltiplica il costo, quindi si aggiunge solo quando un numero (utenti lontani, costo del fermo, obblighi di legge) lo giustifica.
Lascia i tuoi dati nel form qui sotto