Quando conviene usare Dapper invece di Entity Framework Core?
Nei sistemi che durano si usano insieme sulla stessa connessione: Entity Framework Core per i comandi, Dapper per le letture che il profilatore indica come lente.
Marta è la tech lead di un'azienda di logistica a Verona. Il report ordini del gestionale, quello che ogni mattina apre il responsabile del magazzino, impiega nove secondi a comparire. Ha aperto il profilatore di SQL Server e ha trovato una sola query lanciata da Entity Framework Core: 1.900 righe di SQL, sette join, un risultato di oltre tremila righe per un solo ordine. Il collega più anziano le ha detto la frase che si sente in ogni azienda: "Togli l'ORM e scrivi la query a mano". Un altro ha risposto che con Dapper tutto va dieci volte più veloce.
Tutti e due hanno una parte di ragione, e tutti e due rischiano di buttare via mesi di lavoro. Dapper è una libreria piccola, di poche migliaia di righe, che fa una cosa sola: esegue una query SQL che scrivi tu e trasforma le righe in oggetti C#. Non genera SQL, non traccia le modifiche, non gestisce migrazioni. Entity Framework Core fa tutte queste cose, e le paga con un costo di memoria, di complessità e, quando si sbaglia, di velocità.
In questa guida trovi che cos'è Dapper e come funziona davvero, in che cosa il codice cambia rispetto a Entity Framework Core, come si usa in un progetto .NET 10, quando è più veloce e quando la differenza è trascurabile, come si leggono dati da più tabelle, come si scrive senza aprire la porta alla SQL injection, come si usano i due strumenti insieme nello stesso progetto, quali errori si ripetono e come si testa. Alla fine c'è una regola in cinque righe per decidere da soli.
Scrivo software dal 1999 e in aula, quando parlo di accesso ai dati, vedo sempre la stessa scena: la scelta fra i due strumenti si fa per simpatia e non per misura. Qui la facciamo con un caso concreto, un portale ordini su SQL Server, e con numeri che puoi controllare con il tuo profilatore. Se ti serve prima il quadro su Entity Framework Core, ho scritto una guida a Entity Framework Core per accedere ai dati.
Se il tuo gestionale poggia ancora su un file Access, spesso il primo passo è spostare i dati: la guida alla migrazione di un database Access a SQL Server spiega come, con tempi e costi.
Cos'è Dapper e che cosa fa davvero in C#?
Dapper è un micro-ORM per .NET: una libreria che aggiunge metodi di estensione a IDbConnection per eseguire query SQL scritte a mano e trasformare le righe in oggetti C#. Non genera SQL, non traccia le modifiche e non crea il database.
Da dove viene e perché esiste
Dapper nasce dentro Stack Overflow, dove il team (Marc Gravell e Sam Saffron fra i nomi più noti) aveva un problema preciso: un traffico enorme sul database e nessuno spazio per livelli intermedi superflui. La libreria è open source, si installa con un pacchetto NuGet e il suo codice si legge in un pomeriggio. Questo dato conta più di quanto sembri: quando qualcosa va storto, puoi capire che cosa fa la libreria senza leggere un framework da centinaia di migliaia di righe.
Il nome "micro-ORM" descrive bene la divisione dei compiti. Un ORM completo come Entity Framework Core sa tre cose: costruire la query a partire da un'espressione C#, eseguirla e ricordare quello che hai caricato per scrivere poi solo le differenze. Dapper conosce soltanto la seconda metà della prima e nessuna delle altre: prende il tuo testo SQL, lo esegue con i parametri che gli passi e legge il risultato colonna per colonna.
Che cosa fa e che cosa non fa
- Esegue SQL scritto da te:
Query<T>,QueryFirstOrDefault<T>,QuerySingle<T>,Execute,ExecuteScalareQueryMultipleper più risultati in un solo viaggio. - Associa le colonne alle proprietà per nome, senza file di configurazione, e mette in cache il codice di associazione dopo la prima esecuzione.
- Passa parametri con un oggetto anonimo, quindi niente concatenazione di stringhe.
- Non traccia le modifiche: se cambi un oggetto, nessuno scrive l'UPDATE al posto tuo.
- Non crea né migra lo schema: le tabelle le gestisci con script o con uno strumento a parte.
- Non traduce LINQ: il filtro lo scrivi in SQL.
Per questo si dice che Dapper "sta fuori dai piedi". Il programma che lo usa vede una connessione, un testo e una lista di oggetti. Su SQL Server, PostgreSQL, MySQL, SQLite o Oracle funziona nello stesso modo, perché lavora sull'interfaccia standard di ADO.NET che tutti i fornitori implementano. Se oggi usi SqlConnection, SqlCommand e un ciclo while (reader.Read()) per riempire gli oggetti, Dapper è quel ciclo scritto una volta sola e scritto bene.
Un esempio da quattro righe rende l'idea. La classe OrdineRiga ha le proprietà Id, Codice e Quantita. La query ritorna le righe di un ordine.
await using var connessione = new SqlConnection(stringaConnessione);
var righe = await connessione.QueryAsync<OrdineRiga>(
    "SELECT Id, Codice, Quantita FROM OrdineRighe WHERE OrdineId = @ordineId",
    new { ordineId });
Questo è tutto il metodo. La connessione si apre da sola se era chiusa, il parametro viaggia separato dal testo e il risultato è una sequenza di oggetti pronti. Il resto della guida parte da qui.
Dapper contro Entity Framework Core: che cosa cambia nel codice?
Con Entity Framework Core descrivi quello che vuoi in C# e lasci che sia la libreria a produrre il SQL; con Dapper scrivi il SQL e la libreria si occupa solo di consegnarti gli oggetti. La differenza sta nel punto in cui metti la conoscenza del database.
Lo stesso problema, due strade
Prendi la richiesta più comune di un portale ordini: gli ordini non evasi di un cliente, con il nome del cliente e il totale. In Entity Framework Core la scrivi con LINQ: contesto.Ordini.Where(o => o.ClienteId == id && !o.Evaso).Select(o => new OrdineDto(o.Id, o.Cliente.Nome, o.Totale)). Il compilatore controlla i nomi delle proprietà, la rinomina di un campo si propaga con il refactoring e la query cambia insieme al modello. Con Dapper scrivi un testo SQL con il join esplicito: nessun controllo a compile time, ma sai esattamente che cosa parte verso il database, riga per riga.
Che cosa guadagni e che cosa perdi
Entity Framework Core ti dà il controllo dei tipi, la traduzione di LINQ, il tracciamento delle modifiche, le migrazioni dello schema, i filtri globali (utili per il soft delete e per i sistemi con più clienti) e la gestione dei concorrenti con i token di versione. Dapper ti dà l'esecuzione diretta, un consumo di memoria prevedibile e la libertà di usare tutto il SQL che il tuo database conosce: funzioni di finestra, tabelle temporanee, MERGE, hint, query ricorsive. Con Entity Framework Core alcune di queste cose si possono fare, con un po' di lavoro; con Dapper le scrivi come le scriveresti in un client SQL.
- Scrittura: Entity Framework Core calcola da solo gli INSERT, gli UPDATE e l'ordine delle dipendenze con un solo
SaveChangesAsync. In Dapper scrivi ogni comando e l'ordine lo decidi tu. - Lettura: LINQ si legge bene finché la query è semplice. Quando serve una finestra o una query ricorsiva, il SQL è più chiaro di qualsiasi giro di espressioni.
- Cambio di database: Entity Framework Core nasconde in parte le differenze fra fornitori. Con Dapper il SQL è quello del tuo database, e cambiarlo significa riscrivere le query.
- Curva di apprendimento: Dapper si impara in un'ora se conosci SQL. Entity Framework Core richiede settimane per essere usato bene, non per essere usato.
Non esiste un vincitore in assoluto, esiste il confronto sul tuo carico di lavoro. Un gestionale con centinaia di tabelle e scritture complesse beneficia del tracciamento. Un report che legge diecimila righe e le butta in una griglia non ne trae nessun vantaggio e ne paga il costo. Ne parliamo con i numeri nella sezione sulla velocità.
Un'ultima nota sulla manutenzione, quella che nessuno mette nei confronti. Con Entity Framework Core una colonna rinominata rompe la compilazione nei punti giusti. Con Dapper la stessa colonna rinominata rompe il programma in esecuzione, e lo rompe solo quando qualcuno passa dalla riga di codice interessata. Per questo, se scegli Dapper, devi mettere i test sulle query dal primo giorno: ne parliamo più avanti.
Come si installa e si usa Dapper in un progetto .NET 10?
Si aggiunge il pacchetto NuGet Dapper e il fornitore del database (per SQL Server Microsoft.Data.SqlClient), poi si chiamano i metodi di estensione su una connessione aperta. In un progetto ASP.NET Core la connessione si crea per richiesta e si chiude subito.
Il minimo indispensabile
Da riga di comando bastano due pacchetti: dotnet add package Dapper e dotnet add package Microsoft.Data.SqlClient. La stringa di connessione sta in appsettings.json come per Entity Framework Core. Il punto in cui cambiano le abitudini è la gestione della connessione: con Entity Framework Core il contesto la possiede e tu non la vedi, con Dapper la crei tu.
La soluzione più pulita è una piccola fabbrica registrata nel contenitore delle dipendenze. Un'interfaccia IFabbricaConnessioni con un metodo Crea() che ritorna una nuova SqlConnection con la stringa letta dalla configurazione. Ogni repository la riceve nel costruttore e apre una connessione dentro il metodo che serve, con await using. Il pool delle connessioni di ADO.NET riutilizza i canali fisici, quindi aprire e chiudere una connessione per operazione costa pochissimo.
Un repository di lettura
Il pattern che funziona in produzione è un repository per area di funzionalità, con metodi che ritornano oggetti di sola lettura (record) pensati per quella schermata. Un record OrdineInSospeso(int Id, string Cliente, decimal Totale, DateTime Data) e una query scritta per riempirlo. Niente entità del dominio, niente proprietà di navigazione: la forma della risposta è quella che serve a chi la consuma.
public async Task<IReadOnlyList<OrdineInSospeso>> OrdiniInSospeso(int clienteId)
{
    const string sql = @"
        SELECT o.Id, c.Nome AS Cliente, o.Totale, o.Data
        FROM Ordini o
        JOIN Clienti c ON c.Id = o.ClienteId
        WHERE o.ClienteId = @clienteId AND o.Evaso = 0
        ORDER BY o.Data DESC";
    await using var connessione = fabbrica.Crea();
    return (await connessione.QueryAsync<OrdineInSospeso>(sql, new { clienteId })).AsList();
}
Associazione fra colonne e proprietà
Dapper associa per nome, senza distinguere maiuscole e minuscole. Se il database usa nomi con il trattino basso (data_ordine) e le classi usano DataOrdine, si imposta una volta sola DefaultTypeMap.MatchNamesWithUnderscores = true all'avvio. Per i record con costruttore Dapper sceglie il costruttore i cui parametri corrispondono alle colonne, quindi i tipi devono coincidere: una colonna decimal verso un parametro double dà un errore chiaro alla prima esecuzione.
Per le liste di valori nella clausola IN si passa una collezione: WHERE Id IN @ids con new { ids = new[] { 4, 9, 12 } }, e Dapper espande la lista in parametri separati. Per le stored procedure si passa commandType: CommandType.StoredProcedure. Per i parametri di output c'è DynamicParameters. Con queste quattro cose copri il novantacinque per cento delle operazioni di un portale.
Una scelta di metodo prima di chiudere. Metti il testo SQL in costanti vicino al metodo che lo usa e non in file di risorse lontani: chi legge il metodo deve vedere query e parametri nella stessa schermata, perché è in quel confronto che si trovano gli errori.
Scrivere la prima query con Dapper richiede dieci minuti. Decidere dove tenerla, come testarla e quando lasciarla a Entity Framework Core richiede un metodo, e quel metodo si impara su casi veri. Se vuoi vederlo applicato a un progetto con i tuoi dati, il passo successivo è chiederlo.
Dapper è davvero più veloce di Entity Framework Core?
Sì, sulle letture di molte righe e con query semplici, ma la differenza è piccola rispetto al tempo del database e quasi sempre sparisce quando l'Entity Framework Core è usato bene. I due strumenti producono quasi lo stesso SQL: ciò che cambia è il lavoro che avviene dopo che le righe sono arrivate.
Dove si perde tempo davvero
Una richiesta a un portale ordini passa per quattro tappe: costruzione della query, viaggio verso il database ed esecuzione, trasferimento delle righe, creazione degli oggetti. Il database lavora nella seconda, e lì Dapper ed Entity Framework Core sono alla pari, perché mandano lo stesso SQL. Le differenze stanno nella prima e nella quarta. Entity Framework Core deve tradurre l'espressione LINQ (c'è una cache per le query ripetute, quindi il costo si paga una volta) e, nella configurazione di default, registra ogni entità letta nel tracciatore, che mantiene una copia di ogni valore per confrontarlo al salvataggio. Dapper non fa né l'una né l'altra cosa.
Le tre regolazioni che chiudono quasi tutto il divario
AsNoTracking()sulle letture: disattiva il tracciatore. Per un elenco di cinquantamila righe da mostrare e non da modificare è la differenza più grande, perché elimina la copia di ogni valore.- Proiezione con
Selectsu un DTO: porta dal database solo le colonne usate, non l'entità intera con venti campi. - Query compilate con
EF.CompileAsyncQuery: per le query chiamate migliaia di volte al secondo tolgono il costo di traduzione.
Con queste tre misure, sulle letture semplici la distanza fra i due strumenti scende a una frazione di quello che si legge nei confronti di quattro anni fa, quando le versioni erano più lente e il tracciamento era acceso di default anche per i report. Quando misuri, usa il tuo database e i tuoi dati: BenchmarkDotNet per le prove isolate e il profilatore di SQL Server per vedere che cosa viaggia davvero.
Dove la differenza resta, e conta
Resta nei carichi che materializzano molte righe: esportazioni, report con decine di migliaia di righe, importazioni, servizi che leggono e rispondono in un battito. Lì ogni oggetto in meno per riga si moltiplica per il numero di richieste. Resta anche nelle query con più collezioni: un Include su tre raccolte può produrre il prodotto cartesiano, dove un ordine con 40 righe, 15 spedizioni e 6 allegati torna come 3.600 righe, a meno di usare AsSplitQuery(). Con Dapper la stessa operazione sono tre query piccole che scegli tu, per un totale di 61 righe.
La regola per il lavoro quotidiano: non rinunciare a Entity Framework Core per una velocità che non hai misurato. Misura prima la query più lenta del tuo sistema, correggi i difetti ordinari (tracciamento, colonne inutili, N+1), e se il tempo resta fuori budget sposta quella query, una sola, su Dapper.
Come si leggono dati da più tabelle con Dapper?
Si scrive una join esplicita e si usa il multi-mapping: Dapper riempie più oggetti da una riga e splitOn indica da quale colonna comincia il secondo. Per le relazioni uno-a-molti si usa un dizionario di appoggio oppure QueryMultiple.
Multi-mapping: un ordine con il suo cliente
Il caso più frequente è un oggetto con una proprietà che punta a un altro. La query ritorna le colonne dell'ordine seguite da quelle del cliente, e splitOn: "ClienteId" dice a Dapper che da quella colonna in poi i valori vanno nel secondo oggetto. Il punto che fa sbagliare tutti è la colonna di divisione: il valore predefinito è Id, che se la tua tabella ha un'altra chiave ti fa leggere il cliente vuoto senza nessun errore. Quando un oggetto torna con tutte le proprietà a zero, il primo controllo è lì.
var ordini = await connessione.QueryAsync<Ordine, Cliente, Ordine>(
    "SELECT o.Id, o.Data, o.Totale, c.Id AS ClienteId, c.Nome " +
    "FROM Ordini o JOIN Clienti c ON c.Id = o.ClienteId WHERE o.Evaso = 0",
    (ordine, cliente) => { ordine.Cliente = cliente; return ordine; },
    splitOn: "ClienteId");
Uno-a-molti: un ordine con le sue righe
Con una collezione il multi-mapping produce una riga per ogni riga d'ordine, e l'ordine si ripete. Si risolve con un dizionario: la prima volta che incontri l'ordine lo salvi, le volte successive aggiungi la riga a quello già salvato, e alla fine prendi i valori del dizionario. Funziona, ma per una sola collezione è più chiaro usare QueryMultiple: due SELECT in un solo viaggio, le testate prima e le righe dopo, poi le unisci in memoria con un raggruppamento sull'identificativo.
La seconda strada è quella che in produzione dà meno sorprese. Due query piccole e indicizzate costano meno di una join che duplica le colonne larghe dell'ordine su ogni riga, e non esiste il rischio del prodotto cartesiano quando le collezioni diventano due o tre.
Altri aiuti che si usano spesso
- Parametri con valori di tabella: per passare migliaia di identificativi a SQL Server si passa un
DataTableconAsTableValuedParameter, al posto di una listaINche a un certo punto supera i limiti dei parametri. QueryFirstOrDefaulteQuerySingle: il primo tollera zero o più righe, il secondo solleva un'eccezione se le righe non sono esattamente una. Scegli in base a quello che la tua regola di business considera un errore.- Lettura senza buffer: con
buffered: falsele righe arrivano una alla volta mentre le consumi, utile per esportazioni enormi, a patto di tenere la connessione aperta fino alla fine.
Con Entity Framework Core le stesse operazioni si scrivono con Include, ed è più corto. La scelta giusta dipende da chi leggerà quel codice fra due anni: se il team è abituato a SQL, la join esplicita è la forma più leggibile.
Come si scrive in sicurezza con Dapper: transazioni e parametri?
Si passano sempre i valori come parametri, mai concatenati nel testo SQL, e si raggruppano le scritture in una transazione aperta sulla connessione. Dapper non ricorda lo stato: la transazione la gestisci tu e la passi a ogni comando.
La SQL injection si evita in un solo modo
Il parametro @clienteId viaggia al database separato dal testo: il valore non viene mai interpretato come SQL. È la protezione che hai anche con SqlCommand e con Entity Framework Core. L'errore tipico è costruire la stringa con l'interpolazione: $"... WHERE Nome = '{nome}'". Basta un apostrofo nel nome di un cliente perché la query si rompa, e basta un testo costruito apposta perché qualcuno ci scriva dentro un comando. Una sola eccezione comune: i nomi di tabelle e di colonne non si possono parametrizzare. Se un ordinamento scelto dall'utente va nella query (ORDER BY), il nome della colonna si confronta con una lista di valori ammessi che hai scritto tu, e si inserisce solo se coincide.
Scrivere più comandi in una transazione
Per una scrittura che tocca più tabelle (la testata dell'ordine, le righe, il movimento di magazzino) si apre la connessione, si avvia la transazione e si passa a ogni ExecuteAsync con il parametro transaction. Se uno dei comandi fallisce, l'eccezione esce dal blocco try e il Rollback annulla tutto. Se arrivi in fondo, Commit.
await using var connessione = fabbrica.Crea();
await connessione.OpenAsync();
await using var transazione = await connessione.BeginTransactionAsync();
var id = await connessione.ExecuteScalarAsync<int>(
    "INSERT INTO Ordini (ClienteId, Totale) OUTPUT INSERTED.Id VALUES (@ClienteId, @Totale)",
    ordine, transazione);
await connessione.ExecuteAsync(
    "INSERT INTO OrdineRighe (OrdineId, Codice, Quantita) VALUES (@id, @Codice, @Quantita)",
    ordine.Righe.Select(r => new { id, r.Codice, r.Quantita }), transazione);
await transazione.CommitAsync();
Nota la seconda chiamata: se passi una collezione come parametro, Dapper esegue il comando una volta per ogni elemento, nella stessa transazione. Per migliaia di righe questo vuol dire migliaia di viaggi, quindi per le importazioni massicce si usa SqlBulkCopy o un parametro con valori di tabella.
Che cosa devi aggiungere tu
Entity Framework Core ti dà il controllo di concorrenza con le colonne di versione. In Dapper lo scrivi nel SQL: UPDATE ... WHERE Id = @id AND Versione = @versione, e se ExecuteAsync ritorna zero righe modificate, qualcun altro ha cambiato il record e sollevi un'eccezione tua. Lo stesso vale per le date di creazione e modifica, per il soft delete e per l'audit: nessun meccanismo automatico li inserisce, quindi li metti in un punto solo, nei metodi di scrittura, e non nelle query sparse.
Transazioni, parametri e controllo della concorrenza sono il punto in cui un portale ordini smette di essere un esercizio. Chi li ha impostati bene una volta non rifà più gli stessi errori sul progetto dopo. Puoi chiedere come lavoriamo su questi temi in aula.
Si possono usare Dapper ed Entity Framework Core insieme?
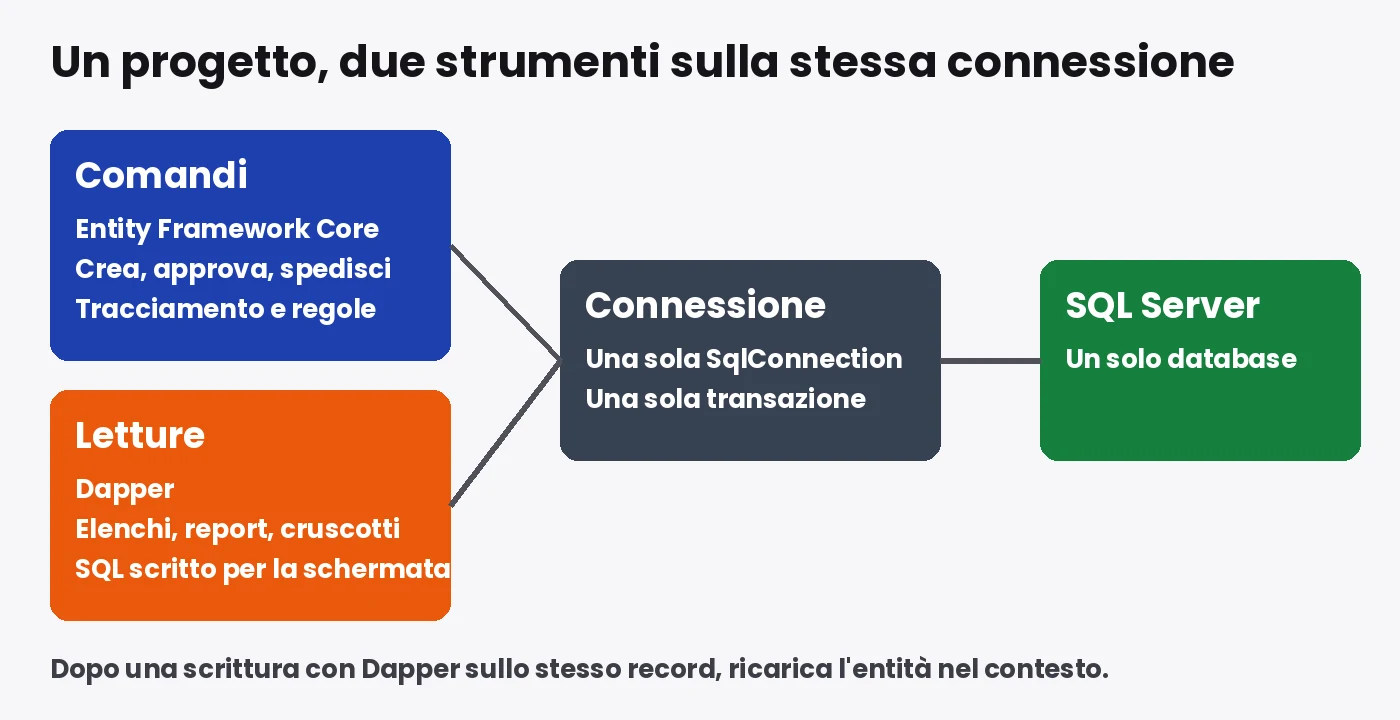
Sì, ed è la scelta più comune nei sistemi che durano: Entity Framework Core per scrivere e per le schermate ordinarie, Dapper per i report e per le letture che pesano. I due strumenti possono condividere la stessa connessione e la stessa transazione.
Come si condivide la connessione
Il contesto di Entity Framework Core espone la connessione ADO.NET sottostante con contesto.Database.GetDbConnection(). Dapper vi lavora sopra senza aprirne un'altra. Se hai una transazione di Entity Framework Core in corso, la ottieni con contesto.Database.CurrentTransaction.GetDbTransaction() e la passi ai comandi di Dapper: tutto avviene nello stesso blocco atomico. Questo ti consente, per esempio, di salvare l'ordine con Entity Framework Core e di chiamare una query di Dapper che calcola il totale con una funzione di finestra, il tutto prima del commit.
Un'architettura che regge: scritture e letture separate
La divisione più pulita segue il principio che molti conoscono come CQRS in versione leggera. Il lato dei comandi (crea ordine, approva, spedisci) usa Entity Framework Core con le entità del dominio, perché lì servono tracciamento, validazioni e regole. Il lato delle query (elenchi, report, cruscotti) usa Dapper con record di sola lettura e SQL scritto per la schermata. Non servono due database né un bus di messaggi: basta una cartella Letture per le query e una cartella Comandi per le scritture. Se ti interessa come l'idea si lega al modello del dominio, la trovi in Domain Driven Design e come funziona, e come organizzare i livelli in Clean Architecture in C#.
I limiti della convivenza
- Il tracciatore non vede le scritture di Dapper. Se modifichi una riga con Dapper e il contesto l'aveva già caricata, il contesto tiene il vecchio valore. Dopo una scrittura di Dapper sullo stesso record, ricarica l'entità o usa un contesto nuovo.
- Le migrazioni conoscono solo il modello. Se Dapper legge una vista o una tabella che non è nel modello di Entity Framework Core, la gestisci con uno script a parte e la metti sotto controllo di versione insieme al resto.
- Due modi di fare le cose si pagano in formazione. Scrivi in un file di regole del team dove si usa uno e dove si usa l'altro, e ripetilo nelle revisioni.
Il risultato, nei progetti che seguo, è che Entity Framework Core copre la gran parte del codice e Dapper compare in una decina di punti, quelli che il profilatore ha indicato. Il resto del sistema resta leggibile a chi non conosce il SQL a memoria.
Quando scegliere Dapper e quando restare su Entity Framework Core?
Dapper conviene quando il SQL è il centro del problema: report, letture massicce, database già esistenti con schemi difficili. Entity Framework Core conviene quando il centro è il modello del dominio e la scrittura. Il progetto media usa tutti e due.
Dapper in primo piano
- Report e cruscotti con query lunghe, funzioni di finestra, tabelle temporanee e viste che nessun LINQ esprime in modo leggibile.
- Database esistente con centinaia di stored procedure e uno schema che non segue le convenzioni: mappare tutto in un modello costa più che chiamare le procedure.
- Servizi di sola lettura chiamati migliaia di volte al minuto, dove ogni allocazione si paga.
- Importazioni ed esportazioni di grandi quantità di righe, con lettura senza buffer e scritture massive.
- Il team conosce bene SQL e non ha tempo di imparare le insidie del tracciamento.
Entity Framework Core in primo piano
- Applicazioni con molte scritture e regole sul modello: il tracciamento calcola per te le differenze e l'ordine degli aggiornamenti.
- Schema che nasce con il codice: le migrazioni tengono database e classi allineati, con la cronologia nel repository.
- Più clienti nello stesso database, dove i filtri globali evitano l'errore di dimenticare una clausola in una query. Un approfondimento nella guida alle applicazioni multi-tenant in .NET.
- Team che cambia spesso: il compilatore segnala i punti rotti da un cambio di modello, e i nuovi arrivati sono produttivi in pochi giorni.
Una regola in cinque righe
Parti con Entity Framework Core. Attiva la registrazione delle query e guarda quelle lente in produzione. Applica prima AsNoTracking, la proiezione e le query divise. Se una query resta fuori budget, riscrivila in Dapper, una sola. Documenta nel repository perché quella query vive fuori dal modello, in una riga sopra il metodo.
C'è un'ultima situazione, quella dei sistemi da ammodernare. Se erediti un'applicazione con ADO.NET puro e DataSet sparsi per cento schermate, passare a Dapper è un passo più corto e più sicuro del passaggio diretto a Entity Framework Core: le query restano quelle che il cliente conosce, sparisce il codice ripetitivo di lettura, e il modello a oggetti arriva un'area per volta. È lo stesso ragionamento a piccoli passi che uso nelle migrazioni, per esempio nel passaggio da ASP.NET WebForms a Core.
Quali errori si fanno più spesso con Dapper?
Gli errori più frequenti sono sei: SELECT *, splitOn sbagliato, query non coperte da test, connessioni tenute aperte troppo a lungo, uso di dynamic e SQL sparso in tutto il progetto. Nessuno è un difetto della libreria; sono le conseguenze di non avere la rete di sicurezza del compilatore.
Gli errori che rompono il programma
SELECT *nei repository. Aggiungi una colonna alla tabella e un record con costruttore smette di corrispondere; togli una colonna e la proprietà torna a zero. Elenca sempre le colonne che servono.splitOnlasciato al valore predefinito. Il secondo oggetto del join torna vuoto, senza nessun errore, e la schermata mostra "cliente: nessuno" per ordini che il cliente ce l'hanno.- Tipi che non coincidono. Una colonna
datetimeverso unDateOnlyo undecimalverso unfloatdà errori a runtime. Le date arrivano conKindnon specificato: decidi una convenzione (UTC nel database) e applicala in un gestore di tipo unico. - Enumerazioni salvate come numero. Funziona finché qualcuno non riordina l'enumerazione. Salva il testo o scrivi i valori numerici esplicitamente nella definizione.
Gli errori che consumano risorse
- Connessione aperta troppo a lungo. Con
buffered: falseo con una transazione lunga la connessione resta occupata; un pool di cento connessioni si esaurisce con cento richieste lente. Apri tardi, chiudi presto. - Query in un ciclo. È l'N+1 di sempre, nascosto in un repository: duecento ordini, duecento query per i clienti. Si risolve con una sola query con
INe un dizionario in memoria. - Liste di parametri enormi. Una lista
INcon cinquemila elementi diventa cinquemila parametri; SQL Server ha un tetto di circa duemila cento parametri per comando. Passa un parametro con valori di tabella.
L'errore di organizzazione
Il peggiore non si vede in nessun profilatore: il SQL scritto in venti file diversi, dentro i controller, nei servizi, nei componenti Blazor. Tre mesi dopo nessuno sa dove cambiare la regola sugli ordini evasi. Il rimedio è un confine netto: il SQL vive solo nelle classi della cartella Letture e Scritture, ogni query ha un nome che dice che cosa risponde, e tutto il resto del programma chiama quei metodi. Chiede un po' di disciplina, e la restituisce al primo cambio di schema.
Un ultimo difetto riguarda Query<dynamic>. Ti fa scrivere meno classi, e ti toglie il compilatore proprio dove serve di più: un nome di campo sbagliato diventa un'eccezione in produzione. Usa record tipizzati, anche per i report, anche se sono usa e getta.
Come si testa il codice che usa Dapper?
Con test di integrazione su un database vero: le query sono SQL, e un database finto non prova nulla sul SQL. Un contenitore con SQL Server avviato dal test, dati minimi e uno schema creato dagli script del progetto.
Perché i mock non servono qui
Un repository Dapper è un sottile strato fra il tuo codice e il database. Se lo sostituisci con un oggetto finto, verifichi che il tuo codice chiami il metodo giusto, non che la query funzioni. I difetti che fanno male stanno altrove: una colonna rinominata, un tipo che non coincide, un splitOn sbagliato, un indice mancante. Si trovano solo eseguendo la query su uno schema reale.
Una struttura di test che regge
- Avvia SQL Server in un contenitore all'inizio della sessione di test. La libreria Testcontainers per .NET lo fa con poche righe e lo spegne alla fine.
- Applica gli script dello schema. Se usi anche Entity Framework Core, le migrazioni creano le tabelle e i test di Dapper le leggono.
- Per ogni test, inserisci i dati minimi con un metodo di appoggio e svuota le tabelle al termine.
- Chiama il repository e confronta il risultato, colonna per colonna, con quello che ti aspetti.
- Aggiungi un test per ogni query che torna oggetti con relazioni: è dove
splitOne i dizionari si rompono.
Dieci test di questo tipo coprono un repository con dieci query e girano in pochi secondi dopo l'avvio del contenitore. Il costo è un'ora di configurazione la prima volta, e ripaga al primo cambio di schema, quando i test rossi ti indicano ogni query da correggere prima che lo faccia un utente.
Che cosa si testa con i test di unità
Le regole di business che stanno attorno alla query: calcolo dei totali, scelta dello stato, validazioni. Questo codice non dipende dal database e si prova in memoria, in millisecondi. La separazione fra letture, scritture e regole rende i test semplici da scrivere e veloci da eseguire. È lo stesso principio che regge un'architettura a strati ben fatta, e se vuoi vedere come si applica in un progetto intero, la guida alla principali design pattern in C# ha gli esempi.
Un repository con i suoi test su un database vero cambia il modo in cui affronti il prossimo cambio di schema. Si impara facendolo con qualcuno che l'ha già fatto in produzione. Se vuoi farlo sul tuo codice, scrivici.
Dapper.AOT e .NET 10: che cosa cambia nel 2026?
Dapper gira su .NET 10 senza adattamenti, e Dapper.AOT è un pacchetto separato che genera il codice di associazione in compilazione per ridurre i costi a runtime e funzionare con la compilazione Native AOT. Prima di adottarlo controlla lo stato della versione.
Che cosa fa Dapper.AOT
Il Dapper classico costruisce il codice di associazione la prima volta che vede una query, usando la riflessione e generando IL a runtime. Dapper.AOT sposta quel lavoro in fase di compilazione con i generatori di sorgenti e gli intercettori di C#: le chiamate ai metodi di Dapper vengono sostituite da codice scritto dal compilatore per quella specifica query e per quel tipo. I vantaggi sono due. L'avvio è più veloce, perché non c'è nulla da costruire alla prima richiesta. E l'applicazione può essere compilata con Native AOT, che non ammette la generazione di codice a runtime. Un bonus: gli analizzatori segnalano durante la compilazione parametri mancanti e colonne non corrispondenti, cioè parte della rete di sicurezza che a Dapper mancava.
Quando conviene guardarlo
- Funzioni serverless e contenitori che si avviano spesso: ogni avvio a freddo costa meno.
- Strumenti da riga di comando e servizi piccoli compilati in Native AOT.
- Progetti con molte query dove gli avvisi del compilatore salvano dalle regressioni.
Per un portale ASP.NET Core che gira per giorni senza fermarsi, l'avvio più rapido conta poco, e il beneficio principale diventano gli avvisi a compile time. Prima di adottarlo in produzione, apri la pagina del pacchetto su NuGet e leggi lo stato della versione e le note di compatibilità: è un progetto in evoluzione, e quello che vale oggi può cambiare.
Entity Framework Core 10 non sta fermo
.NET 10 è una versione a supporto lungo (LTS) uscita a novembre 2025, e porta con sé Entity Framework Core 10. Il motore di traduzione delle query migliora a ogni versione, gli aggiornamenti in blocco con ExecuteUpdate e ExecuteDelete evitano di caricare le entità per cambiarle, e SqlQuery<T> permette di eseguire SQL scritto a mano restituendo tipi che non sono entità. Significa che molti dei casi in cui un tempo si passava a Dapper oggi si risolvono restando dentro Entity Framework Core, con SQL a mano per il pezzo che serve. La questione si sposta: non "ORM o micro-ORM", ma "quanta parte della mia applicazione ha bisogno di vedere il SQL".
Se la tua soluzione è ancora su .NET Framework, il discorso cambia. Dapper funziona anche lì, ed è spesso il modo più economico di togliere il vecchio codice ADO.NET prima di una migrazione. Per i costi di quel passaggio c'è l'analisi sulla migrazione da WebForms a Core, con il conto a più anni.
Marta non ha tolto l'ORM. Ha aperto il profilatore, ha trovato la query dei sette join, l'ha riscritta con una proiezione e due query divise in Entity Framework Core, e ha spostato su Dapper solo il report del magazzino, che legge dodicimila righe e le butta in una griglia. Il report ora risponde in meno di un secondo. Il collega anziano ha avuto la sua query scritta a mano, l'altro ha avuto il suo Dapper, e il resto del portale è rimasto com'era, con le migrazioni, i test e il compilatore dalla sua parte.
Se vuoi arrivare a fare scelte così con la tua testa, imparare a leggere un piano di esecuzione, a decidere dove serve il modello e dove serve il SQL, a progettare l'accesso ai dati di un sistema che deve durare, nel corso C# di Sviluppatore Migliore lavoriamo su progetti reali con il mio feedback diretto, in lezioni registrate e live che si incastrano con il lavoro. Porta la tua query più lenta: la apriamo insieme.
Domande frequenti
Dapper è un micro-ORM open source per .NET: aggiunge metodi di estensione a IDbConnection per eseguire query SQL scritte a mano e trasformare le righe in oggetti C#. Non genera SQL, non traccia le modifiche e non gestisce le migrazioni dello schema.
Sulle letture di molte righe sì, ma la distanza si riduce molto con AsNoTracking, proiezioni su DTO e query compilate. Il tempo del database resta uguale, perché il SQL inviato è simile. Conviene misurare con BenchmarkDotNet e con il profilatore.
Quando il SQL è il centro del problema: report con funzioni di finestra, letture massicce, stored procedure su database esistenti, importazioni ed esportazioni. Per scritture complesse, migrazioni e filtri globali conviene Entity Framework Core.
Sì. Si condivide la connessione con Database.GetDbConnection() e la transazione con CurrentTransaction.GetDbTransaction(). La divisione più comune: Entity Framework Core per i comandi, Dapper per le letture pesanti. Dopo una scrittura con Dapper va ricaricata l'entità.
Solo se passi i valori come parametri (new { id }) e non concateni stringhe nel testo SQL. Nomi di tabelle e colonne non si parametrizzano: vanno confrontati con una lista di valori ammessi scritta da te.
Con test di integrazione su un database vero, per esempio SQL Server in un contenitore avviato con Testcontainers. I mock non provano il SQL. Le regole di business attorno alla query si testano in memoria con test di unità.
È un pacchetto separato che genera in compilazione il codice di associazione di Dapper con generatori di sorgenti e intercettori, riducendo i costi di avvio e rendendo possibile la compilazione Native AOT. Controlla lo stato della versione su NuGet prima di adottarlo.
Lascia i tuoi dati nel form qui sotto