Perché una query di Entity Framework Core è lenta e come si corregge?
Il portale ordini di un distributore di ricambi è andato in produzione a marzo con 300 mila ordini e una pagina "Ordini del cliente" che rispondeva in 90 millisecondi. A novembre gli ordini sono 4,2 milioni, la stessa pagina impiega 4 secondi, il supporto riceve tre telefonate al giorno e qualcuno propone di comprare un server più grosso. Nessuno ha toccato il codice da giugno.
Prendo un caso composito, costruito su situazioni che ho visto più volte: i numeri sono ordini di grandezza realistici e non la misura di un cliente. La storia però finisce quasi sempre così. Il server grosso non serve. Servono tre interventi, fatti nell'ordine giusto: leggere ciò che Entity Framework Core manda davvero al database, guardare il piano di esecuzione che SQL Server sceglie, e correggere la query o l'indice che lo manda fuori strada. Nel caso di questa guida la pagina scende da 4.100 a 38 millisecondi senza nuovo hardware.
Qui sotto trovi il metodo completo: perché una query diventa lenta con la crescita dei dati, come trovare quella colpevole in dieci minuti, come si legge un piano di esecuzione senza essere un amministratore di database, i sei errori di Entity Framework Core che ricorrono di più, gli indici da dichiarare, la paginazione, il caso della query veloce in laboratorio e lenta in produzione, e le prove automatiche che impediscono il ritorno del problema. Se stai ancora scegliendo lo strumento per accedere ai dati, parti da Dapper o Entity Framework Core: qui diamo per buono Entity Framework Core e lo facciamo andare.
Perché una query di Entity Framework Core diventa lenta quando i dati crescono?
Una query diventa lenta quando SQL Server deve leggere molte più righe di quelle che restituisce. Con 300 mila ordini la lettura inutile costa pochi millisecondi, con 4 milioni costa secondi: il codice è lo stesso, è cambiata la quantità di lavoro nascosto.
Entity Framework Core è un traduttore: prende un'espressione LINQ in C# e la trasforma in SQL. Il database poi sceglie come eseguirla, con un componente chiamato ottimizzatore che decide quali indici usare, in che ordine unire le tabelle e quanta memoria riservare. La lentezza nasce quasi sempre in uno di questi due punti, o nella traduzione (il SQL generato è più pesante del necessario) o nella scelta del piano (il database non ha un indice utile, o ha statistiche sbagliate, e legge l'intera tabella).
Il lavoro cresce più dei dati
Una ricerca senza indice legge tutte le righe: con dieci volte i dati, dieci volte il tempo. Un'unione fra due tabelle grosse senza indice sul campo di collegamento può crescere con il quadrato. Per questo la pagina che andava bene ai test (poche centinaia di righe sul computer dello sviluppatore) crolla a produzione piena, e per questo "da giugno nessuno ha toccato niente" è una frase compatibile con un problema serio.
Il tempo si divide in quattro
Quando una richiesta è lenta il tempo si distribuisce fra traduzione della query, esecuzione nel database, trasferimento delle righe e creazione degli oggetti in memoria. Prima di cambiare una riga di codice serve sapere quale delle quattro pesa. Nella maggior parte dei casi che vedo pesa la seconda o la quarta: il database legge troppo, oppure l'applicazione carica migliaia di oggetti che la pagina non mostra.
Il server più grosso compra tempo, non lo risolve
Raddoppiare processore e memoria porta un miglioramento del 20-40% su una query che legge milioni di righe inutili, e costa un canone mensile che resta per sempre. Un indice ben scelto porta un miglioramento del 99% e costa mezza giornata. Il confronto economico fra le due strade, per un gestionale che invecchia, lo trovi in quanto costa davvero il software legacy.
Come si trova la query lenta senza andare a tentativi?
Si trova guardando ciò che l'applicazione manda davvero al database: il registro dei comandi di Entity Framework Core in sviluppo, un intercettore che segnala le query oltre una soglia, e Query Store di SQL Server in produzione. Tre strumenti, nessun costo, un'ora di lavoro.
In sviluppo: guarda il SQL, non il LINQ
Il primo gesto è leggere il SQL generato. Con una riga nella configurazione del contesto, Entity Framework Core scrive ogni comando nella console, con la durata:
// Program.cs: registra il contesto e scrive nella console ogni comando SQL con la sua durata.
builder.Services.AddDbContext<OrdiniDbContext>(opzioni =>
{
    opzioni.UseSqlServer(builder.Configuration.GetConnectionString("Ordini"));

    if (builder.Environment.IsDevelopment())
    {
        opzioni.LogTo(Console.WriteLine,
            new[] { DbLoggerCategory.Database.Command.Name },
            LogLevel.Information);

        // Mostra i valori dei parametri: solo in sviluppo, può contenere dati personali.
        opzioni.EnableSensitiveDataLogging();
    }
});
Per una singola query sospetta c'è un metodo ancora più rapido: ToQueryString() restituisce il SQL senza eseguirlo, pronto da incollare in SQL Server Management Studio.
In produzione: un intercettore che segnala solo le query lente
Il registro completo in produzione genera troppo rumore e può far trapelare dati. Meglio un intercettore che scrive una riga solo quando un comando supera, per esempio, 500 millisecondi:
// Intercettore: segnala nel registro i comandi che superano la soglia.
public sealed class QueryLenteInterceptor(ILogger<QueryLenteInterceptor> registro)
    : DbCommandInterceptor
{
    private static readonly TimeSpan Soglia = TimeSpan.FromMilliseconds(500);

    public override ValueTask<DbDataReader> ReaderExecutedAsync(
        DbCommand comando, CommandExecutedEventData dati,
        DbDataReader risultato, CancellationToken token = default)
    {
        if (dati.Duration > Soglia)
        {
            registro.LogWarning("Query lenta ({Durata} ms): {Sql}",
                (int)dati.Duration.TotalMilliseconds, comando.CommandText);
        }
        return new ValueTask<DbDataReader>(risultato);
    }
}

// Registrazione: opzioni.AddInterceptors(serviceProvider.GetRequiredService<QueryLenteInterceptor>());
Query Store: la memoria storica del database
SQL Server registra da solo, se Query Store è attivo, tempo medio, numero di esecuzioni e piano usato per ogni query. In Management Studio, sotto il database, la voce "Query Store" e il rapporto "Top Resource Consuming Queries" ti mostrano le dieci query che consumano di più, ordinate per tempo totale. La più pericolosa non è sempre la più lenta: una query da 80 millisecondi chiamata 400 mila volte al giorno pesa più di una da 6 secondi chiamata due volte. Aggiungi TagWith("Elenco ordini del cliente") alle query importanti: il commento compare nel SQL e ti dice da quale punto del codice arriva.
Come si legge il piano di esecuzione di SQL Server?
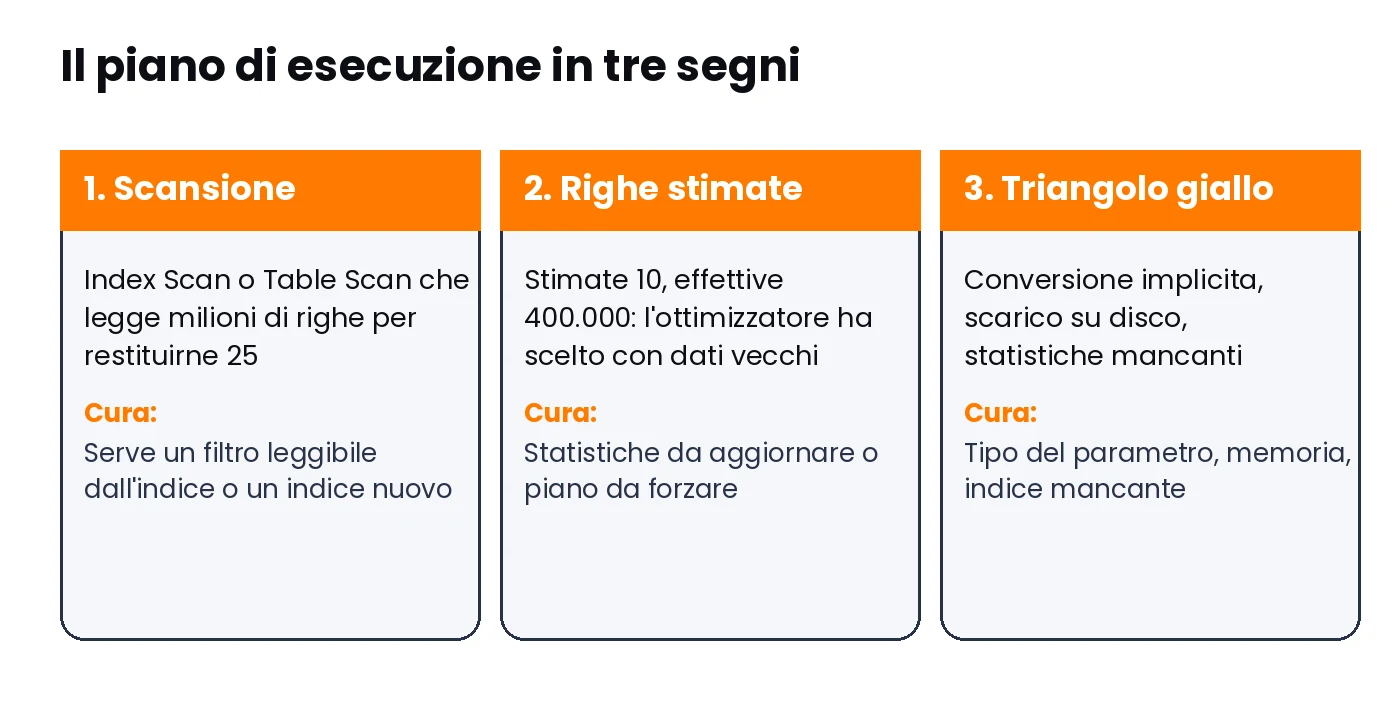
Il piano di esecuzione è la mappa dei passi che SQL Server segue per rispondere. Si legge da destra a sinistra e dall'alto in basso, cercando tre segnali: letture di tutta la tabella, righe stimate molto diverse dalle righe reali, avvisi gialli. Basta questo per la maggior parte dei problemi.
In Management Studio si attiva con Ctrl+M (piano reale), poi si esegue la query. Prima di guardare il disegno aggiungi due righe: SET STATISTICS IO ON; SET STATISTICS TIME ON;. Nel pannello "Messaggi" compare il numero di letture logiche, cioè quante pagine di 8 KB il database ha dovuto leggere. È la misura più onesta: il tempo cambia da un'esecuzione all'altra, le letture no.
I quattro operatori da riconoscere
Un Index Seek trova le righe usando l'indice, come cercare un cognome in una rubrica ordinata: è quello che vuoi vedere. Un Index Scan o un Table Scan legge tutto dall'inizio alla fine, come scorrere la rubrica pagina per pagina: su 4 milioni di righe è il colpevole. Un Key Lookup trova la riga con l'indice ma poi torna alla tabella a prendere le altre colonne, e se succede 20 mila volte diventa un problema. Un Sort ordina in memoria e, se la memoria stimata era troppo piccola, scarica su disco.
Righe stimate contro righe reali
Passa il mouse sulla freccia fra due operatori: vedi "Numero di righe stimate" e "Numero di righe effettive". Se il piano si aspettava 10 righe e ne sono arrivate 400 mila, l'ottimizzatore ha scelto la strada sbagliata perché aveva informazioni vecchie. Si aggiornano le statistiche (UPDATE STATISTICS), oppure si scopre che il filtro è scritto in un modo che le rende inutilizzabili, come vedremo fra poco.
I triangoli gialli e i dati mancanti
Un triangolo giallo su un operatore segnala un avviso: scarico su disco, conversione implicita, statistiche mancanti. Il piano mostra anche, in verde, la definizione di un "indice mancante" suggerito. Va letto come un indizio e non come una ricetta: il suggerimento non sa niente delle altre query e spesso propone indici troppo larghi. Prima di copiarlo, chiediti quale filtro lo ha generato.
Un caso: la pagina da 4 secondi
La pagina "Ordini del cliente" mostrava, nel piano reale, una scansione dell'indice sugli ordini con 4,2 milioni di righe lette per restituirne 25, 11 mila letture di chiave per le altre colonne e un ordinamento su disco. Tre segnali in un solo disegno. Le sezioni che seguono li correggono uno alla volta.
Sapere leggere un piano di esecuzione è la competenza che separa chi "prova a vedere se va meglio" da chi sa dove guardare. Si impara in un pomeriggio, con una query vera davanti. Se ti serve qualcuno che lo faccia con te sul tuo progetto, il passo successivo è chiederlo.
Perché un Include a più livelli rallenta la pagina e come lo si sostituisce?
Ogni Include aggiunge colonne e righe duplicate al risultato: con ordini, righe e prodotti in un'unica query il database restituisce una riga per ogni combinazione, e l'applicazione le ricompone una per una. La cura è caricare solo le colonne che la pagina mostra, con una proiezione.
La query originale della pagina era questa, e a prima vista non ha niente di sbagliato:
// Prima: carica interi ordini, righe e prodotti, anche se la pagina mostra cinque campi.
var ordini = await db.Ordini
    .Include(o => o.Cliente)
    .Include(o => o.Righe).ThenInclude(r => r.Prodotto)
    .Where(o => o.ClienteId == clienteId && o.DataOrdine.Year == 2026)
    .OrderByDescending(o => o.DataOrdine)
    .Skip(pagina * 25).Take(25)
    .ToListAsync();
L'esplosione cartesiana in una frase
Un ordine con 12 righe, caricato insieme alle righe, produce 12 righe di risultato che ripetono tutte le colonne dell'ordine. Se aggiungi una seconda collezione (per esempio le note), le righe diventano 12 per il numero di note. Con tre livelli e pagine di 25 ordini, la query può riportare migliaia di righe larghe per mostrare una tabella di 25 righe. Entity Framework Core lo sa e registra un avviso (MultipleCollectionIncludeWarning) quando succede: se non lo hai mai letto, apri il registro.
La proiezione: chiedi solo ciò che mostri
La pagina mostra numero ordine, data, nome del cliente, totale e numero di righe. Quindi la query deve chiedere queste cinque cose:
// Dopo: una proiezione su un tipo di sola lettura, senza tracciamento.
public sealed record OrdineInElenco(
    int Id, string Numero, DateTime DataOrdine, string Cliente, decimal Totale, int NumeroRighe);

var ordini = await db.Ordini
    .AsNoTracking()
    .TagWith("Elenco ordini del cliente")
    .Where(o => o.ClienteId == clienteId)
    .OrderByDescending(o => o.DataOrdine)
    .Skip(pagina * 25).Take(25)
    .Select(o => new OrdineInElenco(
        o.Id, o.Numero, o.DataOrdine, o.Cliente.RagioneSociale, o.Totale, o.Righe.Count))
    .ToListAsync();
Con la proiezione Entity Framework Core non ha bisogno di Include: genera una sola query con le colonne richieste e un conteggio. AsNoTracking() toglie il tracciatore, il componente che tiene una copia di ogni valore letto per accorgersi delle modifiche. Su 25 oggetti è poco; su un'esportazione da 20 mila è la differenza fra mezzo secondo e quattro.
Quando serve davvero caricare le collezioni
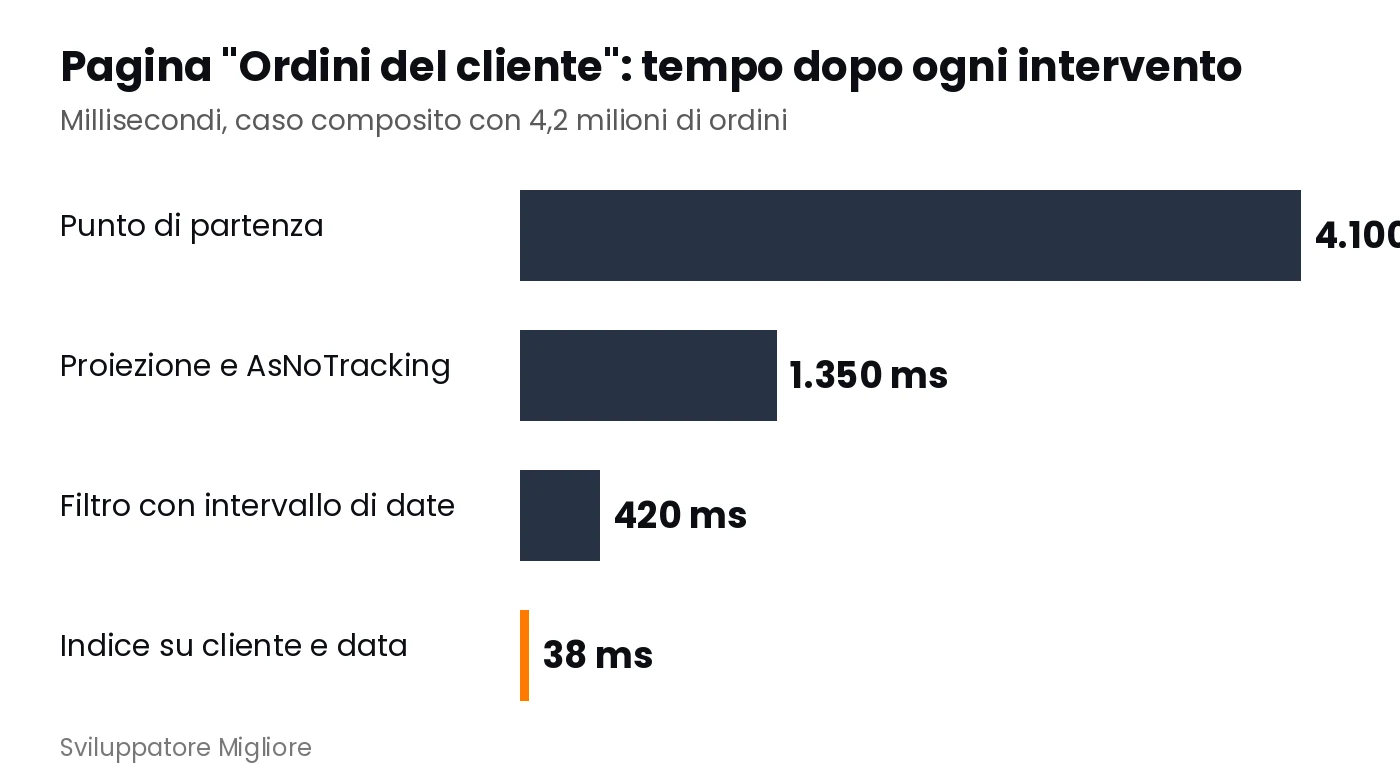
Se devi modificare l'ordine e le sue righe, il caricamento completo ha senso. In quel caso usa AsSplitQuery(): invece di un'unica query con le righe duplicate, Entity Framework Core manda una query per collezione e le ricompone. Costa un viaggio in più verso il database e toglie la moltiplicazione. Nel caso della pagina questi due interventi, proiezione e niente tracciamento, hanno portato il tempo da 4.100 a 1.350 millisecondi. Resta molto lavoro: il database continua a leggere troppo.
Quali filtri LINQ impediscono a SQL Server di usare l'indice?
Un filtro impedisce l'uso dell'indice quando applica una funzione alla colonna: anno estratto da una data, testo trasformato in minuscolo, ricerca che comincia con un carattere jolly. SQL Server deve calcolare il valore per ogni riga, quindi legge tutta la tabella.
Gli esperti chiamano "non sargable" un filtro scritto così: il nome indica che l'indice non può essere cercato con quell'argomento. La regola pratica è semplice: la colonna deve restare nuda a sinistra del confronto, e tutto il lavoro si sposta sul valore a destra.
Anno estratto da una data
Il filtro o.DataOrdine.Year == 2026 viene tradotto in DATEPART(year, [DataOrdine]) = 2026. L'indice sulla data non serve a niente, perché il database dovrebbe calcolare l'anno di ogni riga. Si riscrive come intervallo:
// Prima: funzione sulla colonna, indice inutilizzabile.
.Where(o => o.DataOrdine.Year == 2026)

// Dopo: intervallo semiaperto, l'indice sulla data lavora con una ricerca.
var da = new DateTime(2026, 1, 1);
var a  = new DateTime(2027, 1, 1);
.Where(o => o.DataOrdine >= da && o.DataOrdine < a)
Testo in minuscolo e ricerche con il jolly iniziale
Su SQL Server il confronto fra testi non distingue maiuscole e minuscole con la collazione predefinita, quindi ToLower() prima del confronto è lavoro inutile che spegne l'indice. Un filtro Contains("rossi") diventa LIKE '%rossi%': con il jolly all'inizio nessun indice normale può aiutare. Se la ricerca deve essere veloce su milioni di righe, le strade sono un StartsWith (che usa l'indice) oppure un indice di ricerca a testo completo, che SQL Server mette a disposizione e che Entity Framework Core interroga con EF.Functions.Contains.
La conversione implicita che nessuno vede
Questo è l'errore più subdolo. Per Entity Framework Core una stringa C# è per impostazione predefinita un nvarchar (testo Unicode). Se la colonna nel database è varchar, ogni confronto costringe SQL Server a convertire la colonna riga per riga, e nel piano appare un triangolo giallo con la dicitura "CONVERT_IMPLICIT". Si risolve in una riga nella configurazione del modello:
// OrdiniDbContext.OnModelCreating: la colonna è varchar, quindi il parametro deve esserlo.
modelBuilder.Entity<Ordine>()
    .Property(o => o.Numero)
    .HasMaxLength(20)
    .IsUnicode(false);
Nel nostro caso la sostituzione dell'anno con un intervallo ha portato la pagina da 1.350 a 420 millisecondi. Il piano mostrava ancora una ricerca nell'indice sulla sola data e 11 mila letture di chiave: serviva un indice fatto per questa query.
Quali indici servono davvero e come si dichiarano in Entity Framework Core?
Serve un indice fatto sulla forma della query: prima le colonne che filtrano per uguaglianza, poi quelle dell'ordinamento, poi le altre colonne necessarie nella parte "inclusa" dell'indice, così da evitare il ritorno alla tabella. Si dichiara nel modello e lo crea la migrazione.
Un indice è un secondo archivio, ordinato, che SQL Server mantiene accanto alla tabella. Rende le letture veloci e le scritture un po' più lente, perché ogni inserimento aggiorna anche lui. Di conseguenza non si mette un indice su ogni colonna: se ne mette uno per ciascuna query importante.
L'ordine delle colonne conta
La pagina cerca gli ordini di un cliente e li mostra dal più recente. L'indice giusto ha come prima colonna ClienteId (filtro per uguaglianza) e come seconda DataOrdine in ordine decrescente (ordinamento): SQL Server trova il cliente, trova già in ordine gli ordini e si ferma dopo 25 righe. Con le colonne invertite l'indice non servirebbe.
// OrdiniDbContext.OnModelCreating: indice per la pagina "Ordini del cliente".
modelBuilder.Entity<Ordine>()
    .HasIndex(o => new { o.ClienteId, o.DataOrdine })
    .IsDescending(false, true)
    .IncludeProperties(o => new { o.Numero, o.Totale })
    .HasDatabaseName("IX_Ordini_Cliente_Data");
Le colonne incluse eliminano il ritorno alla tabella
Le colonne nell'IncludeProperties sono copiate nell'indice senza influire sull'ordinamento. Siccome la pagina mostra numero e totale, SQL Server trova tutto nell'indice e non deve tornare alla tabella: le 11 mila letture di chiave del piano scompaiono. Questo è il motivo per cui un indice "mancante" suggerito da Management Studio funziona: in genere propone proprio queste colonne.
Indici filtrati e il costo da pagare
Se il 95% degli ordini è chiuso e la pagina mostra quasi sempre quelli aperti, un indice filtrato con .HasFilter("[Stato] <> 'Chiuso'") è piccolo e veloce. Ogni indice in più costa spazio e rallenta le scritture di qualche punto percentuale: misura prima e dopo, e togli quelli che nessuna query usa (la vista sys.dm_db_index_usage_stats dice quante volte sono stati letti).
Con l'indice la pagina è scesa da 420 a 38 millisecondi. In ordine: 4.100, poi 1.350, 420 e 38. Tre interventi, nessun server nuovo, due giorni di lavoro. Per una migrazione già fatta, vale la regola di come portare un database Access su SQL Server: gli indici si disegnano sulle query reali, non sulle tabelle.
Questo tipo di lavoro (decidere quali indici tenere, quali togliere, come verificare che reggano a dieci volte i dati) è il cuore di quello che insegno a chi vuole progettare l'accesso ai dati di un sistema che deve durare. Se vuoi vederlo applicato alla tua query più lenta, il passo successivo è chiederlo.
Che cos'è il problema N+1 e come si riconosce nel registro?
Il problema N+1 si verifica quando il codice esegue una query per l'elenco e poi una query in più per ogni elemento dell'elenco. Con 25 righe sono 26 viaggi al database; con 2.000 sono 2.001. Si riconosce dal registro, dove lo stesso SQL compare decine di volte.
È l'errore che incontro più spesso, perché nasce da codice che sembra pulito. Un ciclo foreach che scorre gli ordini e per ognuno legge il cliente con una chiamata a FindAsync non dà errori e funziona su cento righe di prova. In produzione ogni viaggio verso il database costa 1-3 millisecondi di sola rete, e 2.000 viaggi sono 2-6 secondi.
Le tre forme in cui si presenta
La prima è il ciclo esplicito, come sopra. La seconda è il caricamento pigro (lazy loading), cioè l'accesso a una proprietà di navigazione che scatena una query nascosta: se hai installato il pacchetto dei proxy e usi virtual sulle proprietà, ogni ordine.Cliente.RagioneSociale dentro un ciclo è una query. La terza è la proprietà calcolata in C# che usa una collezione non caricata. Ne ho parlato in dettaglio in come ottimizzare il caricamento pigro in Entity Framework.
Come trovarlo in due minuti
Apri il registro dei comandi, carica la pagina e cerca righe SQL identiche che differiscono solo per il valore del parametro. Se vedi WHERE [c].[Id] = @p0 ripetuto trenta volte, hai trovato il problema. Un controllo più rapido è contare i comandi: un solo caricamento di pagina dovrebbe produrre una manciata di query, non centinaia.
La cura: una query sola, o due ben fatte
Si sostituisce il ciclo con una proiezione (come nella sezione precedente) oppure si carica in blocco gli elementi correlati con una sola query e Contains su un elenco di identificativi. Dalla versione 8 Entity Framework Core traduce Contains su un elenco in modo efficiente anche con migliaia di valori, ma sopra qualche migliaio conviene passare da una tabella temporanea o da un parametro di tipo tabella. Per scritture e cancellazioni in massa, ExecuteUpdateAsync e ExecuteDeleteAsync fanno in un solo comando ciò che prima richiedeva di caricare ogni riga e salvarla.
La paginazione con Skip e Take regge anche a pagina 4.000?
No: Skip e Take diventano più lenti a ogni pagina, perché il database deve comunque leggere e scartare tutte le righe precedenti. Per elenchi lunghi si usa la paginazione per chiave: si chiede "le 25 righe dopo l'ultima vista", non "salta le prime 100 mila".
Entity Framework Core traduce Skip(n).Take(25) in OFFSET n ROWS FETCH NEXT 25 ROWS ONLY. Alla pagina 3 il costo è trascurabile. Alla pagina 4.000 di un elenco con ordinamento su una colonna senza indice, SQL Server ordina un milione di righe per restituirne 25. Gli utenti non arrivano quasi mai alla pagina 4.000, ma un sistema di esportazione o un robot che scorre l'elenco sì.
La paginazione per chiave
Invece del numero di pagina, il client rimanda la data e l'identificativo dell'ultima riga ricevuta, e la query riparte da lì:
// Paginazione per chiave: tempo costante a ogni pagina, purché esista l'indice (DataOrdine, Id).
var pagina = await db.Ordini
    .AsNoTracking()
    .Where(o => o.DataOrdine < ultimaData
             || (o.DataOrdine == ultimaData && o.Id < ultimoId))
    .OrderByDescending(o => o.DataOrdine).ThenByDescending(o => o.Id)
    .Take(25)
    .Select(o => new OrdineInElenco(o.Id, o.Numero, o.DataOrdine, o.Cliente.RagioneSociale, o.Totale, o.Righe.Count))
    .ToListAsync();
Il compromesso è che non si può saltare a una pagina qualsiasi: si va avanti e indietro. Per cruscotti e flussi di lavoro è un vantaggio, per un elenco con "pagina 17 di 240" resta il metodo classico, ma con un limite al numero di pagine raggiungibili.
Il conteggio totale costa quanto la lettura
La scritta "4.213.870 ordini trovati" richiede un CountAsync() su tutta la tabella filtrata. Su filtri larghi è la query più lenta della pagina. Le alternative sono mostrare "più di 10.000" (contando fino a un tetto con Take(10001).CountAsync()), tenere un contatore aggiornato ogni notte, o eliminare il numero e mostrare solo "pagina successiva". Quasi nessun utente se ne accorge, e il tempo della pagina si dimezza.
Le query compilate: utili, ma non sono la cura
Entity Framework Core mette in memoria la traduzione delle query ripetute, quindi il costo di traduzione si paga una volta. EF.CompileAsyncQuery toglie anche il piccolo lavoro che resta, e su percorsi chiamati migliaia di volte al secondo fa risparmiare qualche decimo di millisecondo per chiamata. Se la tua query impiega 4 secondi, il problema è nel database e la compilazione non lo tocca. Usala alla fine, quando tutto il resto è già a posto.
Perché la query è veloce in Management Studio e lenta nell'applicazione?
Quasi sempre per la sensibilità ai parametri: SQL Server costruisce il piano con il primo valore ricevuto e lo riusa per tutti i successivi. Se il primo valore è raro e il successivo è comune, il piano è sbagliato per la maggior parte delle chiamate.
Ti è capitato: copi la query dal registro, la esegui in Management Studio con un valore, risponde in 40 millisecondi. L'applicazione impiega 6 secondi con un altro valore. Nessuno dei due mente. SQL Server confeziona il piano la prima volta che vede la query e lo mette in memoria. Un cliente con 40 ordini e un cliente con 600 mila ordini hanno bisogno di strade diverse (cercare nell'indice e poi tornare alla tabella nel primo caso, leggere tutto in blocco nel secondo), ma il piano è uno solo.
Come confermare il sospetto
Il segno è la variabilità: la stessa query, due clienti, due tempi molto diversi. In Query Store, nel rapporto "Query con piani multipli", compaiono le query che SQL Server ha eseguito con più piani, ciascuno con il suo tempo medio. Se un piano costa 20 volte l'altro, hai trovato il colpevole. Un altro indizio: dopo un riavvio o un aggiornamento delle statistiche il problema scompare per qualche ora, perché il piano viene rifatto.
Le tre cure, dalla più sicura alla più invasiva
La prima è forzare il piano buono da Query Store: si seleziona il piano veloce e si preme "Force Plan", senza toccare il codice. È la cura che consiglio per prima, perché è reversibile in un clic. La seconda è lasciare che SQL Server ricompili la query a ogni chiamata, con un suggerimento OPTION (RECOMPILE): costa qualche millisecondo di CPU a chiamata ed è accettabile per pagine poco frequenti e pesanti. Entity Framework Core non ha un metodo dedicato per i suggerimenti, quindi si aggiungono con un intercettore (che riconosce il commento di TagWith e accoda il suggerimento al testo del comando) oppure si scrive la query a mano con FromSqlRaw. La terza è dividere la query in due, una per i clienti piccoli e una per i grandi, quando la differenza è strutturale.
Statistiche e manutenzione
Un piano sbagliato nasce anche da statistiche vecchie. SQL Server le aggiorna da solo quando cambia una certa quota delle righe, ma su tabelle da milioni di righe la soglia è alta. Un lavoro notturno che aggiorna le statistiche delle tabelle principali e ricostruisce gli indici più frammentati costa dieci minuti di configurazione e previene la maggior parte di queste sorprese. Se il problema è il tipo di archivio e non la query, il confronto con un database non relazionale è in quando conviene Azure Cosmos DB.
Un'ultima nota: non toccare mai in produzione un indice o un piano senza un modo per tornare indietro. Scrivi il comando di annullamento prima di quello di applicazione.
Come si impedisce che le query lente tornino?
Si impedisce con tre controlli automatici: un test che conta quante query produce una pagina, una base di prova con volumi realistici, e un allarme sulle query oltre soglia in produzione. Se un controllo scatta, la modifica non passa.
La maggior parte delle query lente non nasce da un errore grave: nasce da una modifica piccola (un Include in più, un filtro riscritto) che nessuno ha misurato. Il rimedio è mettere la misura dove le modifiche passano, cioè nei test.
Un test che conta le query
Il test registra quanti comandi SQL esegue un'operazione e fallisce se superano un tetto. Basta un intercettore che incrementa un contatore:
// Contatore di comandi usato nei test di integrazione.
public sealed class ContatoreComandi : DbCommandInterceptor
{
    public int Totale { get; private set; }

    public override ValueTask<InterceptionResult<DbDataReader>> ReaderExecutingAsync(
        DbCommand comando, CommandEventData dati,
        InterceptionResult<DbDataReader> risultato, CancellationToken token = default)
    {
        Totale++;
        return new ValueTask<InterceptionResult<DbDataReader>>(risultato);
    }
}

// Test xUnit: la pagina degli ordini deve usare al massimo 3 query.
[Fact]
public async Task ElencoOrdini_NonSuperaTreQuery()
{
    var contatore = new ContatoreComandi();
    await using var db = CreaContesto(contatore);   // contesto di prova con l'intercettore

    await servizio.ElencoAsync(db, clienteId: 42, pagina: 0);

    Assert.True(contatore.Totale <= 3, $"Query eseguite: {contatore.Totale}");
}
Questo test intercetta il problema N+1 il giorno in cui qualcuno lo introduce, e costa un quarto d'ora di scrittura.
Una base di prova con i volumi veri
Una query lenta con 4 milioni di righe è veloce con 300. Per questo serve una base dati di prova con volumi realistici: una copia anonimizzata della produzione, oppure un generatore di dati sintetici che crea milioni di righe con la stessa distribuzione (pochi clienti enormi, molti clienti piccoli, che è proprio la condizione in cui il piano sbaglia). Si usa un contenitore con SQL Server per rigenerarla a ogni esecuzione della pipeline notturna, e si misura il tempo delle dieci pagine principali con una soglia.
Un allarme in produzione
L'intercettore visto all'inizio, collegato a Application Insights o a un sistema di registri, fa partire un avviso quando una query supera i 500 millisecondi più di tot volte in un'ora. Metti un limite alto all'inizio, per non fare rumore, e abbassalo ogni mese. Dopo tre mesi hai una pagina con le query ordinate per peso e un elenco di cosa sistemare: è la differenza fra gestire un sistema e subirlo. La stessa disciplina serve a chi sta ristrutturando codice vecchio, come racconto in refactoring di codice legacy con l'intelligenza artificiale.
Quanto tempo e quanto costa mettere a posto le query lente di un gestionale?
Per un gestionale con cinque-dieci pagine critiche servono 3-6 giorni persona, quindi 1.800-3.600 euro a 600 euro al giorno. Un server più potente costa lo stesso nell'arco di un anno e non toglie la causa. Il primo giorno basta per sapere se il problema è nel codice o nei dati.
Il lavoro si divide in modo prevedibile. Un giorno per la misura: registro dei comandi, Query Store, elenco ordinato delle dieci query più pesanti. Da uno a tre giorni per correggere le query e dichiarare gli indici. Un giorno per i test che impediscono il ritorno del problema e per l'allarme. Il resto è margine per le sorprese, come una pagina che usa un report scritto vent'anni fa o una vista con cinque livelli di viste.
La procedura, in sette passi
- Attiva il registro dei comandi in sviluppo e l'intercettore delle query lente in produzione.
- Apri Query Store e ordina per tempo totale: segna le prime dieci.
- Per ciascuna, incolla il SQL in Management Studio con
Ctrl+MeSET STATISTICS IO ON. - Cerca scansioni, letture di chiave, righe stimate contro effettive, triangoli gialli.
- Correggi in quest'ordine: proiezione, filtri leggibili dall'indice, indice, paginazione.
- Misura le letture logiche prima e dopo, e annotale accanto alla modifica.
- Aggiungi il test di conteggio e la soglia di tempo, poi passa alla query successiva.
Quando non basta
Se dopo questa procedura le pagine restano lente, il problema è strutturale: un modello dei dati che non rispecchia le domande dell'utente, report che dovrebbero leggere da una copia separata, oppure una tabella da centinaia di milioni di righe che chiede il partizionamento. Sono interventi di architettura, e conviene affrontarli con il contesto complessivo. La divisione fra comandi e letture, spesso la mossa giusta, è raccontata in CQRS: quando il pattern conviene, e la sua base concettuale in Domain-Driven Design in C#. Se invece il dubbio è se riscrivere o sistemare, prova con riscrivere o rifattorizzare.
Il distributore di ricambi non ha comprato il server più grosso. Ha tolto due livelli di Include dalla pagina, ha scritto l'anno come intervallo di date, ha dichiarato un indice da otto righe di C# e ha aggiunto un test che conta le query. La pagina che impiegava quattro secondi risponde in 38 millisecondi, il supporto non riceve più telefonate sull'argomento e il titolare ha speso meno di tremila euro.
Se vuoi arrivare a diagnosticare queste cose da solo, leggere un piano di esecuzione, decidere dove serve un indice e dove serve cambiare la query, progettare l'accesso ai dati di un sistema che deve reggere anni di crescita, nel corso C# di Sviluppatore Migliore lavoriamo su progetti veri con il mio feedback diretto, in lezioni registrate e sessioni dal vivo che si incastrano con il lavoro. Porta la tua query più lenta: la apriamo insieme.
La tua azienda ha bisogno di software su misura o di AI nel team?
Progettiamo e sviluppiamo software su misura, modernizziamo i sistemi vecchi e formiamo i tuoi sviluppatori a lavorare con l'AI. Raccontaci il problema: ricevi una risposta concreta entro un giorno lavorativo.
Domande frequenti
Perché SQL Server legge molte più righe di quelle che restituisce: manca un indice utile, il filtro applica una funzione alla colonna, un Include carica righe duplicate o il codice esegue una query per ogni elemento. Il registro dei comandi e il piano di esecuzione dicono quale delle cause pesa.
Si attiva il registro dei comandi con LogTo in sviluppo, si aggiunge un intercettore che segnala i comandi oltre una soglia (per esempio 500 millisecondi) e si apre Query Store in SQL Server per vedere le dieci query che consumano di più. ToQueryString mostra il SQL di una singola query.
Si attiva il piano reale con Ctrl+M in Management Studio e si cerca: scansioni di indice o tabella al posto delle ricerche, righe stimate molto diverse dalle effettive, letture di chiave numerose e triangoli gialli. SET STATISTICS IO ON aggiunge le letture logiche, la misura più stabile.
Spesso sì, ma solo se ha le colonne giuste nell'ordine giusto: prima i filtri per uguaglianza, poi l'ordinamento, poi le colonne incluse per evitare il ritorno alla tabella. Un filtro che applica una funzione alla colonna, come l'anno estratto da una data, rende inutile qualsiasi indice.
È il caso in cui il codice esegue una query per l'elenco e una in più per ogni elemento, tipicamente in un ciclo o per un caricamento pigro. Con 2.000 righe sono 2.001 viaggi al database. Si risolve con una proiezione, un Include mirato o un caricamento in blocco.
Di solito per la sensibilità ai parametri: SQL Server costruisce il piano con il primo valore ricevuto e lo riusa. Se il valore successivo ha una distribuzione molto diversa, il piano è sbagliato. Query Store permette di forzare il piano buono senza toccare il codice.
Per cinque-dieci pagine critiche servono 3-6 giorni persona, quindi 1.800-3.600 euro con una tariffa di riferimento di 600 euro al giorno. Un server più potente costa una cifra simile in un anno e lascia intatta la causa.
Lascia i tuoi dati nel form qui sotto