Qual è il numero che decide se serve il pattern CQRS?
Sotto 10 a 1 non serve CQRS; fra 10 e 100 a 1 con almeno tre forme di lettura convengono modelli separati sullo stesso database; sopra 100 a 1 può servire un database di lettura separato. In un'azienda di 45 persone a 56 a 1, i primi due gradini costavano 12.960 euro con un ritorno netto di circa 9.456 euro l'anno e rientro in circa 16 mesi.
Sono le dieci di un martedì e in un'azienda di distribuzione di 45 persone il telefono dell'ufficio ordini squilla senza sosta. Gli operatori inseriscono ordini, e a ogni invio la schermata si ferma per quattro secondi. Il motivo è sempre lo stesso: alle dieci parte il report del controllo di gestione, che legge le stesse tabelle su cui scrivono gli operatori.
Il responsabile IT, che ha letto da qualche parte che esiste un pattern per questo, chiede al team: "Non dovremmo fare CQRS?". Il team risponde con tre sigle e un preventivo da quaranta giornate.
Questo articolo ti dice che cos'è il pattern CQRS, quando in un gestionale .NET si ripaga e quando è solo complessità comprata a caro prezzo. Con i conti fatti, in euro, e con il numero che decide da quale gradino partire.
Troverai la definizione senza gergo, il problema che il pattern risolve davvero, un'azienda tipo con i suoi numeri, la soglia che separa "non serve" da "serve", i quattro gradini con i costi, il codice C# per i primi tre, la differenza con event sourcing e microservizi, gli errori che vedo più spesso e i casi in cui la risposta giusta è un indice sul database.
Una premessa onesta. Dal 1999 progetto e mantengo software per aziende, quasi tutto in .NET. Ho costruito LegalDesk, un programma per studi legali multi-tenant, e ho visto CQRS usato bene in tre sistemi e usato male in molti di più. Non vendo un framework né un corso su questo: ti dico quando conviene e quando no.
Il caso che uso in tutto l'articolo è un'azienda tipo, costruita con ordini di grandezza e medie di settore: 45 persone, 14 in ufficio, un gestionale .NET su SQL Server vecchio di undici anni, un portale clienti e un'app per gli agenti. Non è un cliente, è un metodo. Lo rifai con i tuoi numeri in un pomeriggio.
Che cos'è il pattern CQRS, spiegato senza gergo?
CQRS sta per Command Query Responsibility Segregation, cioè separazione delle responsabilità fra comandi e interrogazioni. Dietro il nome importante c'è un'idea da una riga.
Il codice che cambia i dati e il codice che li mostra sono due cose diverse, e hanno modelli diversi.
Un comando è una richiesta di fare qualcosa: crea l'ordine, annulla la spedizione, applica lo sconto. Cambia lo stato del sistema e può essere rifiutato. Una interrogazione (in inglese query) è una domanda: dammi gli ordini aperti di questo cliente. Non cambia niente e restituisce un risultato.
Nella maggior parte dei gestionali la stessa classe fa entrambe le cose. L'entità Ordine ha quaranta campi, regole di validazione, collegamenti a cliente, righe, spedizioni, e la usi per salvare un ordine nuovo e per riempire la griglia dell'elenco. Funziona finché l'applicazione è piccola.
Con CQRS rompi questo accoppiamento. Per scrivere usi un modello pensato per far rispettare le regole. Per leggere usi un modello pensato per mostrare i dati in fretta, nella forma che serve alla schermata.
L'idea ha una storia. Nel 1988 Bertrand Meyer, il padre del linguaggio Eiffel, formulò il principio della separazione fra comandi e interrogazioni: un metodo o cambia lo stato o restituisce un valore, non entrambe le cose. Intorno al 2010 Greg Young e Udi Dahan portarono lo stesso principio a livello di architettura, separando anche i modelli. È quello il CQRS di cui si parla oggi.
Prima di andare avanti, tre cose che CQRS non è, perché la confusione costa milioni di euro in progetti sbagliati.
- Non è event sourcing. L'event sourcing salva la storia degli eventi invece dello stato. Si usano spesso insieme, ma sono due decisioni separate e la seconda costa molto di più.
- Non sono i microservizi. Puoi fare CQRS dentro un solo programma, con un solo database. I microservizi sono una scelta di distribuzione, CQRS è una scelta di modello.
- Non richiede due database. Due database sono uno dei gradini possibili, non il punto di partenza.
Questa terza riga è la più importante di tutto l'articolo. Quasi tutti i preventivi che vedo partono dal gradino più alto, quando per il 90 per cento delle aziende bastano i primi due.
Qual è il problema che CQRS risolve davvero?
Non è la velocità. Questo è l'equivoco più diffuso, e porta a progetti che rendono il sistema più complicato senza renderlo più veloce.
Il problema vero è un altro: scrivere e leggere hanno forme diverse, e un modello solo le tiene incatenate.
Prendi l'ordine. Quando lo scrivi, ti servono le regole: il cliente esiste ed è attivo, ogni codice articolo è in anagrafica, le quantità sono multipli della confezione, il fido non è sforato. Il modello di scrittura è ricco di logica e stretto, perché ogni campo mal scritto è un guaio in contabilità.
Quando lo leggi, ti servono cose completamente diverse, e sono almeno cinque.
- L'elenco degli ordini aperti per l'ufficio: numero, ragione sociale, data di consegna, totale, stato.
- La scheda dell'ordine sul portale clienti, con lo stato della spedizione e il link al tracciamento.
- Il report del controllo di gestione, con margine per cliente e per famiglia di prodotto.
- L'esportazione per la contabilità, con i campi nel formato del programma contabile.
- La schermata dell'agente in giro, che vuole solo i suoi ordini e una dozzina di campi.
Con un modello solo, ogni schermata aggiunge un campo, un collegamento, un filtro alla stessa entità. L'entità cresce, la query dell'elenco arriva a nove tabelle in join, e ogni modifica a una lettura rischia di rompere la scrittura, perché passano dallo stesso codice.
Questo è il costo vero, e si misura in giornate di sviluppo, non in millisecondi: ogni richiesta di modifica costa più test, più rischio e più giorni di quanto dovrebbe.
CQRS taglia questo nodo. Il modello di scrittura resta piccolo e rigoroso. I modelli di lettura sono tanti, piatti, ognuno fatto su misura per una schermata, e si possono cambiare senza toccare le regole.
La velocità arriva come effetto collaterale, perché una lettura piatta e ben indicizzata è molto più veloce di una catena di join. Ma se il tuo unico problema è una query lenta, quasi sempre la soluzione costa un decimo.
Com'è fatta l'azienda tipo e da quali numeri parte?
L'azienda tipo distribuisce componenti, ha 45 persone di cui 14 in ufficio e un gestionale scritto in .NET undici anni fa, con un solo modello Entity Framework e un solo database SQL Server. Intorno al gestionale sono cresciuti nel tempo un portale clienti e un'app per gli agenti.
Ecco i numeri di partenza, quelli che rilevi in mezza giornata con il registro delle query del database e i log dell'applicazione.
| Misura | Valore | Come si rileva |
|---|---|---|
| Ordini inseriti al mese | 38.000, cioè circa 1.727 al giorno lavorativo | Conteggio sulla tabella degli ordini |
| Letture al giorno | circa 96.000 (ufficio, portale, app agenti, report) | Log delle richieste o statistiche delle query |
| Rapporto letture su scritture | circa 56 a 1 | 96.000 diviso 1.727 |
| Dimensione delle tabelle | 2,4 milioni di testate, 11 milioni di righe | Conteggio righe |
| Elenco ordini aperti, 95° percentile | 2,8 secondi, con 9 tabelle in join | Strumento di monitoraggio o log con i tempi |
| Inserimento ordine alle 10:00 durante il report | da 140 millisecondi a 4,1 secondi | Tempi del comando nel periodo del report |
| Forme diverse di lettura | 5 | Elenco delle schermate e delle esportazioni |
| Richieste di modifica a una lettura nell'ultimo anno | 31, delle quali 19 hanno toccato anche il codice di scrittura | Tracker dei ticket |
| Costo di una giornata di sviluppo | 480 euro (costo pieno) | Costo interno o tariffa del fornitore |
Qualche nota, perché ogni riga è una scelta e devi poterla discutere.
- Il rapporto 56 a 1 è il numero che userai fra poco. Non serve la precisione: serve sapere se sei a 3, a 50 o a 500.
- I 4,1 secondi alle dieci sono il sintomo che fa arrabbiare gli operatori, ma non sono la diagnosi. Qui è una lettura lunga che blocca le scritture, e la cura di base costa pochissimo.
- Le 31 richieste di modifica sono la riga più sottovalutata. Se non hai un tracker, contale a memoria con chi sviluppa: ordine di grandezza basta.
- I 480 euro a giornata sono un costo pieno per uno sviluppatore interno o una tariffa media di fornitore. Se nella tua azienda è diverso, cambia quel numero e il resto si adegua.
Prima di leggere oltre, rifai questa tabella con i tuoi dati. Non servono misure perfette: servono ordini di grandezza e un pomeriggio con chi sviluppa.
Qual è il numero che decide se serve il pattern CQRS?
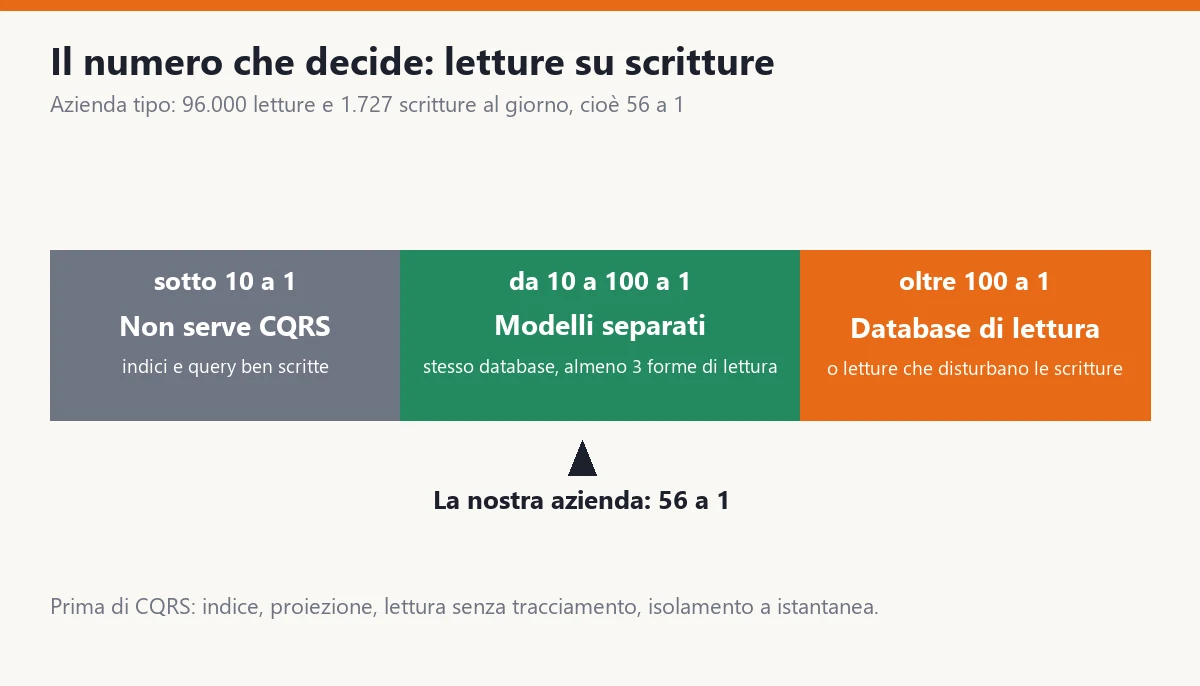
Il numero che decide è il rapporto fra letture e scritture, letto insieme a quante forme diverse di lettura devi servire. Non il numero di utenti, non la dimensione del database, non quanto sia moderno il team.
Il motivo è semplice. CQRS ti fa pagare adesso (più codice, più classi, più cose da tenere allineate) per poter scalare e cambiare le letture separatamente dalle scritture. Se leggi poco o leggi sempre nello stesso modo, quella separazione non ti dà niente.
Le soglie che uso per un gestionale aziendale:
- Sotto 10 a 1 e meno di tre forme di lettura. Non serve CQRS. Indici giusti, query scritte con una proiezione e un po' di pulizia risolvono tutto. Un progetto costerebbe più di quanto recupera.
- Fra 10 a 1 e 100 a 1, con almeno tre forme di lettura. Conviene separare comandi e interrogazioni nel codice e dare alle letture più pesanti un modello proprio sullo stesso database. È la fascia di quasi tutte le PMI che incontro.
- Sopra 100 a 1, oppure letture che disturbano le scritture anche dopo le cure di base. Ha senso un database di lettura separato, aggiornato in modo asincrono, accettando che i dati arrivino con un piccolo ritardo.
La nostra azienda è a 56 a 1, con cinque forme di lettura. Sta nella fascia di mezzo: modelli di lettura sullo stesso database. Il database separato non le serve, e non le servirebbe nemmeno con il portale cresciuto del 50 per cento.
C'è una regola che viene prima di tutte le soglie, e la scrivo in grande perché salva un sacco di soldi.
Prima di CQRS si fanno le cure di base, e solo se restano problemi si passa al pattern.
Le cure di base sono quattro. Un indice sulle colonne che usi nei filtri. Le query di lettura scritte con una proiezione, cioè che chiedono solo le colonne che servono invece di caricare l'entità intera. L'opzione di lettura senza tracciamento di Entity Framework. E, su SQL Server, l'isolamento delle letture a istantanea (si chiama READ COMMITTED SNAPSHOT), che impedisce a una lettura lunga di bloccare chi scrive.
Nel nostro caso queste quattro cure costano 3 giornate, cioè 1.440 euro. Il tempo di inserimento alle dieci torna da 4,1 secondi a circa 210 millisecondi. L'elenco degli ordini scende da 2,8 a 1,1 secondi. Non è ancora un buon risultato, ma il sintomo che faceva arrabbiare gli operatori è sparito.
Quello che resta, e che le cure non toccano, sono le 31 richieste di modifica l'anno che costano troppo. Ed è qui che CQRS comincia a ripagarsi.
Quali sono i quattro gradini del pattern CQRS?
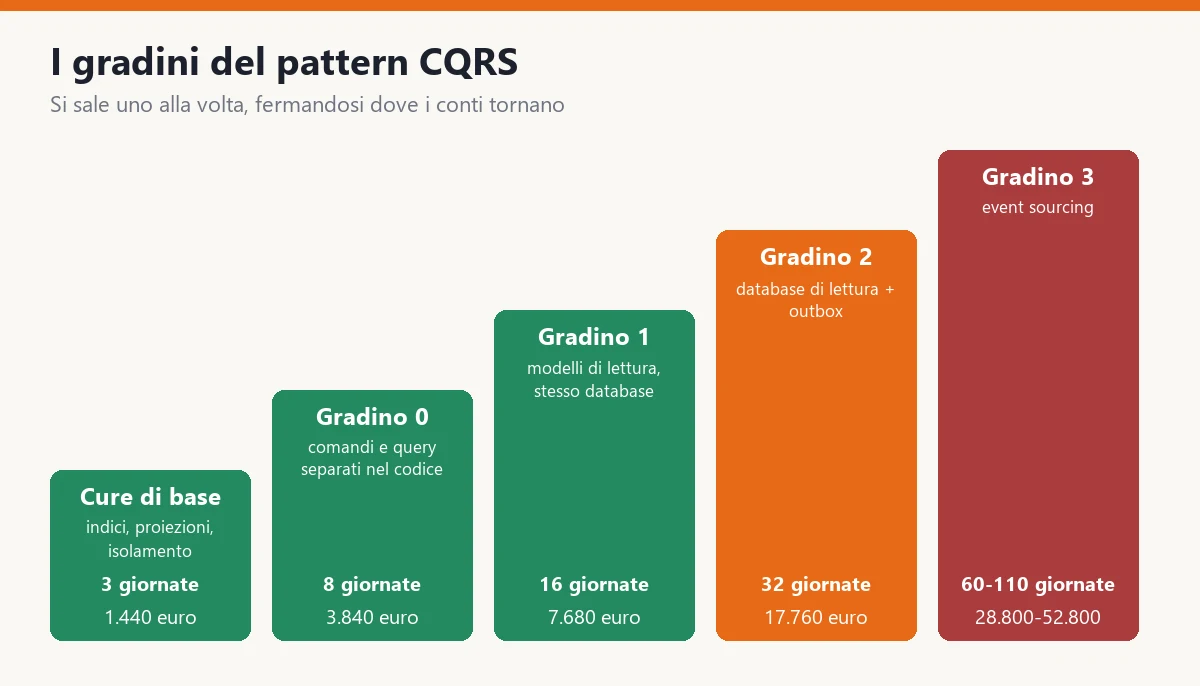
CQRS non è un interruttore da accendere. È una scala, e si sale un gradino alla volta fermandosi dove i conti tornano. Ogni gradino costa più del precedente e aggiunge un tipo di rischio nuovo.
| Gradino | Che cosa compri | Giornate | Primo anno | Anni successivi |
|---|---|---|---|---|
| Cure di base | Indici, proiezioni, lettura senza tracciamento, isolamento a istantanea | 3 | 1.440 euro | 0 |
| Gradino 0 | Comandi e interrogazioni separati nel codice, stesso modello e stesso database | 8 | 3.840 euro | 0 |
| Gradino 1 | Modelli di lettura piatti sullo stesso database, aggiornati nella stessa transazione | 16 | 7.680 euro | circa 960 euro |
| Gradino 2 | Database di lettura separato, aggiornato con la tecnica dell'outbox | 32 | 15.360 euro più 2.400 di infrastruttura | circa 5.472 euro |
| Gradino 3 | Event sourcing: la storia degli eventi al posto dello stato | da 60 a 110 | da 28.800 a 52.800 euro | circa il 20% l'anno |
I costi si sommano, perché ogni gradino poggia sul precedente. Sono ordini di grandezza per una PMI italiana nel 2026 e non preventivi: cambiano con la qualità del codice di partenza e con quanto è coperto dai test.
Il gradino 3 lo cito per completezza. Lo raccomando solo quando hai un requisito che lo impone, come una tracciabilità di legge su ogni cambiamento di stato o la necessità di ricostruire lo stato com'era a una data. Per tutti gli altri è un costo che non si ripaga.
Nelle prossime tre sezioni vediamo il codice dei gradini 0, 1 e 2, perché la differenza fra un'idea e un sistema che funziona sta nei dettagli.
Gradino 0: come si separano comandi e interrogazioni nel codice?
Il primo passo non cambia il database e non cambia il modello. Cambia dove metti il codice. Ogni operazione di scrittura diventa una classe a sé, con un solo scopo. Ogni lettura anche.
Non serve nessuna libreria. Due interfacce da dieci righe bastano, e puoi sostituirle con una libreria di mediazione più avanti, se un giorno ti servirà.
public interface ICommandHandler<TCommand, TResult>
{
    Task<TResult> HandleAsync(TCommand command, CancellationToken ct);
}

public interface IQueryHandler<TQuery, TResult>
{
    Task<TResult> HandleAsync(TQuery query, CancellationToken ct);
}

public sealed record RigaNuova(string CodiceArticolo, decimal Quantita);

public sealed record CreaOrdine(Guid ClienteId, IReadOnlyList<RigaNuova> Righe);

public sealed class CreaOrdineHandler(GestionaleDbContext db, TimeProvider clock)
    : ICommandHandler<CreaOrdine, Guid>
{
    public async Task<Guid> HandleAsync(CreaOrdine cmd, CancellationToken ct)
    {
        if (cmd.Righe.Count == 0)
            throw new DominioException("Un ordine senza righe non si crea.");

        var cliente = await db.Clienti.SingleOrDefaultAsync(c => c.Id == cmd.ClienteId, ct)
            ?? throw new DominioException("Il cliente non esiste.");

        if (!cliente.Attivo)
            throw new DominioException("Il cliente non è attivo.");

        var codici = cmd.Righe.Select(r => r.CodiceArticolo).Distinct().ToList();
        var articoli = await db.Articoli
            .Where(a => codici.Contains(a.Codice))
            .ToDictionaryAsync(a => a.Codice, ct);

        var ordine = Ordine.Crea(cliente, clock.GetUtcNow());

        foreach (var riga in cmd.Righe)
        {
            if (!articoli.TryGetValue(riga.CodiceArticolo, out var articolo))
                throw new DominioException($"Codice articolo sconosciuto: {riga.CodiceArticolo}.");

            ordine.AggiungiRiga(articolo, riga.Quantita);
        }

        db.Ordini.Add(ordine);
        await db.SaveChangesAsync(ct);
        return ordine.Id;
    }
}
Nota tre cose. Il comando è un oggetto semplice con i soli dati che servono, non un'entità. Tutte le regole stanno nel gestore e nell'entità, dove le trovi in un punto solo. E il comando restituisce soltanto l'identificativo: chi ha bisogno dell'ordine completo lo chiede con un'interrogazione.
Ora la lettura. È una classe separata, che non passa dall'entità Ordine con le sue regole, ma proietta direttamente le colonne che servono alla schermata.
public sealed record ElencoOrdiniAperti(int Pagina, int PerPagina);

public sealed record OrdineInElenco(
    Guid Id, string Numero, string Cliente,
    DateOnly DataConsegna, decimal Totale, string Stato);

public sealed class ElencoOrdiniApertiHandler(GestionaleDbContext db)
    : IQueryHandler<ElencoOrdiniAperti, IReadOnlyList<OrdineInElenco>>
{
    public async Task<IReadOnlyList<OrdineInElenco>> HandleAsync(
        ElencoOrdiniAperti q, CancellationToken ct)
    {
        return await db.Ordini
            .AsNoTracking()
            .Where(o => o.Stato != StatoOrdine.Chiuso)
            .OrderBy(o => o.DataConsegna)
            .Skip((q.Pagina - 1) * q.PerPagina)
            .Take(q.PerPagina)
            .Select(o => new OrdineInElenco(
                o.Id, o.Numero, o.Cliente.RagioneSociale,
                o.DataConsegna, o.Totale, o.Stato.ToString()))
            .ToListAsync(ct);
    }
}
Che cosa hai ottenuto con otto giornate? Una regola di condotta che si legge nel codice: chi scrive non legge per mostrare, chi legge non scrive. Quando arriva la trentaduesima richiesta di nuova colonna nell'elenco, tocchi la classe dell'elenco e solo quella. Il comando di creazione non si accorge di niente, e i suoi test non devono essere rifatti.
Questo gradino da solo, senza altro, toglie metà del rischio delle modifiche. Per molte aziende è il punto dove ci si ferma, ed è un'ottima scelta.
Gradino 1: come si danno alle letture pesanti un modello proprio?
Se dopo il gradino 0 hai ancora letture lente o troppo costose da tenere in piedi, il passo successivo è dare a quelle letture una tabella tutta loro, piatta e pronta da mostrare. Resta lo stesso database e resta la stessa transazione.
L'elenco degli ordini aperti, che oggi mette in join nove tabelle, diventa una lettura di una sola tabella.
CREATE SCHEMA lettura;
GO

CREATE TABLE lettura.OrdiniLista (
    OrdineId      uniqueidentifier NOT NULL PRIMARY KEY,
    Numero        nvarchar(20)     NOT NULL,
    Cliente       nvarchar(200)    NOT NULL,
    DataConsegna  date             NOT NULL,
    Totale        decimal(18,2)    NOT NULL,
    Stato         tinyint          NOT NULL,
    Aggiornato    datetime2        NOT NULL
);

CREATE INDEX IX_OrdiniLista_Stato_Consegna
    ON lettura.OrdiniLista (Stato, DataConsegna)
    INCLUDE (Numero, Cliente, Totale);
L'indice include le colonne che l'elenco mostra, quindi la query non deve nemmeno tornare alla tabella: la risposta sta tutta nell'indice. Su 2,4 milioni di testate, l'elenco passa da 1,1 secondi (dopo le cure di base) a circa 0,35.
La parte delicata è tenere questa tabella allineata. Al gradino 1 lo fai nello stesso punto in cui scrivi l'ordine, nella stessa transazione. Se la scrittura fallisce, fallisce anche la tabella di lettura, e non si disallinea mai.
// Dentro CreaOrdineHandler, prima di SaveChangesAsync:
db.OrdiniLista.Add(new OrdineLista
{
    OrdineId = ordine.Id,
    Numero = ordine.Numero,
    Cliente = cliente.RagioneSociale,
    DataConsegna = ordine.DataConsegna,
    Totale = ordine.Totale,
    Stato = (byte)ordine.Stato,
    Aggiornato = clock.GetUtcNow().UtcDateTime
});

await db.SaveChangesAsync(ct); // ordine e riga di lista nascono insieme, o non nasce nulla
Poi l'elenco legge da db.OrdiniLista invece di attraversare nove tabelle, e la schermata non sa più niente della struttura dell'ordine.
Ci sono tre prezzi da conoscere.
- Ogni scrittura fa un po' più di lavoro. Nel nostro caso l'inserimento passa da 210 a circa 240 millisecondi. È un prezzo trascurabile, ma va misurato.
- Ogni nuovo evento che cambia l'elenco va gestito. Annullare l'ordine, cambiare la data di consegna, spedire: ognuno deve aggiornare la tabella di lettura. Si dimenticano, e il sintomo è un ordine che nell'elenco ha lo stato sbagliato.
- Serve un modo per ricostruire tutto. Una procedura che svuota la tabella e la riempie da zero partendo dai dati veri. Senza, il giorno che trovi un'incongruenza non sai come uscirne.
Con 16 giornate (7.680 euro) più un'attenzione continua di circa due giornate l'anno (960 euro), hai tolto dall'elenco il legame con la struttura dell'ordine. Una nuova colonna nella lista non tocca più la scrittura.
Per l'azienda tipo, questo è il gradino dove il conto torna. Lo vediamo fra poco, con i numeri.
Gradino 2: quando serve un database di lettura separato?
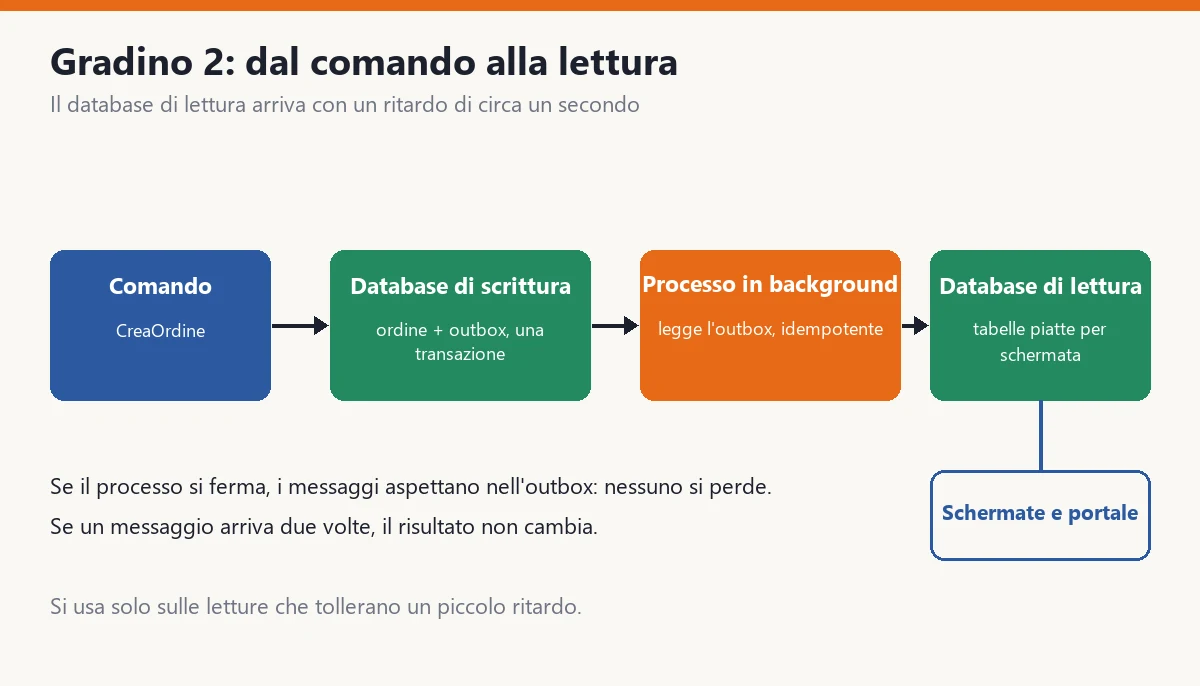
Il gradino 2 serve in due casi. Il primo: le letture sono così tante (sopra i 100 a 1) che pesano sull'hardware e ti obbligherebbero a comprare un database molto più grande. Il secondo: le letture hanno bisogno di una tecnologia diversa, per esempio una ricerca testuale su milioni di righe, che il database delle scritture non sa fare bene.
Il prezzo è la cosa più importante da capire di tutto il pattern: i dati di lettura arrivano con un ritardo. Chi inserisce un ordine e subito dopo apre l'elenco può non vederlo per un secondo o due. Questa si chiama consistenza eventuale, e porta con sé una domanda che nessun fornitore ti fa: la tua azienda può tollerarla?
In un elenco ordini sì, con un avviso e un ricaricamento. In un controllo della disponibilità di magazzino prima di confermare una vendita, no. Il gradino 2 si usa solo sulle letture che reggono il ritardo.
La tecnica che uso per aggiornare il database di lettura senza perdere messaggi si chiama outbox. L'idea: insieme all'ordine scrivi, nella stessa transazione, un messaggio che dice "ordine creato". Un processo in background legge i messaggi non ancora elaborati e aggiorna il database di lettura.
La garanzia sta nella transazione unica: o ci sono ordine e messaggio, o non c'è nulla. Non esiste la situazione in cui l'ordine è salvato e il messaggio perso.
public sealed class MessaggioOutbox
{
    public Guid Id { get; set; }
    public string Tipo { get; set; } = "";
    public string Payload { get; set; } = "";
    public DateTime Creato { get; set; }
    public DateTime? Elaborato { get; set; }
}

public sealed record OrdineCreato(
    Guid OrdineId, string Numero, string Cliente,
    DateOnly DataConsegna, decimal Totale, byte Stato);

// Nel CreaOrdineHandler, insieme a db.Ordini.Add(ordine):
db.Outbox.Add(new MessaggioOutbox
{
    Id = Guid.NewGuid(),
    Tipo = nameof(OrdineCreato),
    Payload = JsonSerializer.Serialize(new OrdineCreato(
        ordine.Id, ordine.Numero, cliente.RagioneSociale,
        ordine.DataConsegna, ordine.Totale, (byte)ordine.Stato)),
    Creato = clock.GetUtcNow().UtcDateTime
});
await db.SaveChangesAsync(ct); // ordine e messaggio: una sola transazione
Dall'altra parte, il processo che aggiorna la lettura. Il punto delicato è che deve essere idempotente, cioè poter elaborare lo stesso messaggio due volte senza fare danni. Se il processo si interrompe fra l'aggiornamento della lettura e la marcatura del messaggio, al riavvio lo rielabora, e il risultato deve essere identico.
public sealed class ProiettoreOrdini(IServiceScopeFactory scopes) : BackgroundService
{
    protected override async Task ExecuteAsync(CancellationToken stop)
    {
        while (!stop.IsCancellationRequested)
        {
            using var scope = scopes.CreateScope();
            var scrittura = scope.ServiceProvider.GetRequiredService<GestionaleDbContext>();
            var lettura = scope.ServiceProvider.GetRequiredService<LetturaDbContext>();

            var messaggi = await scrittura.Outbox
                .Where(m => m.Elaborato == null)
                .OrderBy(m => m.Creato)
                .Take(100)
                .ToListAsync(stop);

            foreach (var m in messaggi)
            {
                if (m.Tipo == nameof(OrdineCreato))
                {
                    var e = JsonSerializer.Deserialize<OrdineCreato>(m.Payload)!;
                    var riga = await lettura.OrdiniLista.FindAsync(new object[] { e.OrdineId }, stop);

                    if (riga is null)
                    {
                        riga = new OrdineLista { OrdineId = e.OrdineId };
                        lettura.OrdiniLista.Add(riga);
                    }

                    riga.Numero = e.Numero;
                    riga.Cliente = e.Cliente;
                    riga.DataConsegna = e.DataConsegna;
                    riga.Totale = e.Totale;
                    riga.Stato = e.Stato;
                    riga.Aggiornato = DateTime.UtcNow;
                }

                m.Elaborato = DateTime.UtcNow;
            }

            await lettura.SaveChangesAsync(stop);
            await scrittura.SaveChangesAsync(stop);

            if (messaggi.Count == 0)
                await Task.Delay(TimeSpan.FromSeconds(1), stop);
        }
    }
}
Sono cento righe di codice che sembrano un esercizio, ma nascondono il lavoro vero: cosa fai se il processo è fermo da un'ora? Come ti accorgi che i messaggi si accumulano? Chi ricostruisce la lettura se si corrompe? Quale allarme suona se il ritardo supera i dieci secondi?
Queste domande costano la maggior parte delle 32 giornate. Il codice che scrivi è poco, il sistema che lo circonda è molto. Per questo il gradino 2 non è un'evoluzione naturale del gradino 1: è un'altra categoria di progetto, con un'altra manutenzione.
Quanto costa il pattern CQRS e quando si ripaga?
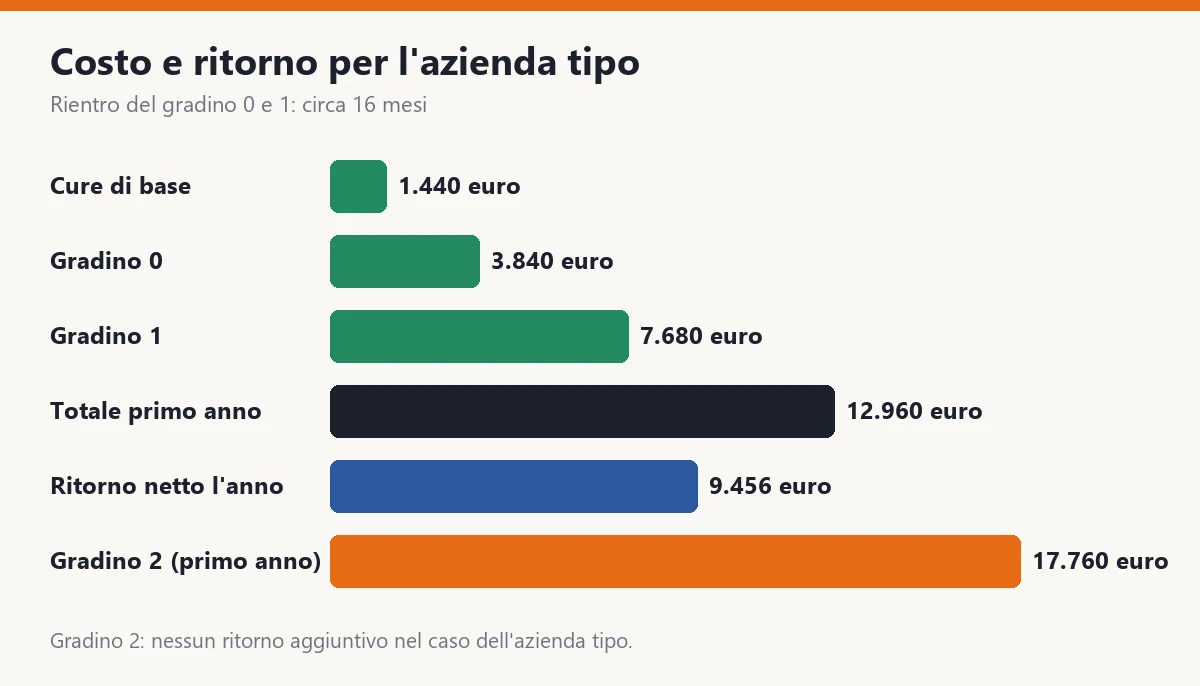
Torniamo ai numeri dell'azienda tipo, e alla domanda che conta: che cosa si recupera?
Il ritorno più solido, quello che puoi difendere davanti a un amministratore, è il costo delle modifiche. Nell'ultimo anno sono arrivate 31 richieste di modifica a una lettura. Con il modello unico ciascuna è costata in media 1,6 giornate, fra sviluppo, test e rischio di toccare la scrittura. Con modelli separati stimo 0,9 giornate. La differenza è 0,7 giornate per richiesta.
Il conto: 31 richieste × 0,7 giornate = 21,7 giornate, cioè circa 10.416 euro l'anno. Tolti i 960 euro di manutenzione dei modelli di lettura, il ritorno netto è di 9.456 euro l'anno.
| Voce | Importo |
|---|---|
| Cure di base (3 giornate) | 1.440 euro |
| Gradino 0 (8 giornate) | 3.840 euro |
| Gradino 1 (16 giornate) | 7.680 euro |
| Costo totale del primo anno | 12.960 euro |
| Risparmio sulle modifiche (21,7 giornate) | 10.416 euro l'anno |
| Manutenzione dei modelli di lettura | meno 960 euro l'anno |
| Ritorno netto | 9.456 euro l'anno |
| Rientro | circa 16 mesi |
Il rientro è 12.960 diviso 9.456, cioè 1,37 anni, circa 16 mesi. Non è un investimento miracoloso e non deve esserlo: è un lavoro che si ripaga, con un numero che puoi controllare dopo sei mesi.
Nel conto non ho messo il tempo risparmiato dagli operatori. L'elenco più veloce fa guadagnare ai 14 dell'ufficio circa 35 minuti al giorno in totale, cioè circa 126 ore l'anno, 3.500 euro. Lo lascio fuori di proposito, perché è la voce più facile da gonfiare e la prima che un amministratore smonta. Se vuoi tenerlo, sono un bonus.
E il gradino 2? Per l'azienda tipo costa 17.760 euro il primo anno e 5.472 negli anni successivi, e non porta nessun ritorno aggiuntivo: il database di scrittura regge le 96.000 letture al giorno, e le modifiche costano già 0,9 giornate. Si ripagherebbe soltanto se il portale clienti crescesse di dieci volte, o se ti obbligasse a comprare un database più grande.
Per rendere concreto il confronto: salire di fascia sul database costa circa 1.900 euro al mese, 22.800 euro l'anno. Se il tuo problema è davvero il carico, e non la manutenibilità, quel numero è il tetto di quanto ti conviene spendere nel gradino 2. Sopra quella cifra, comprare potenza costa meno che costruire.
Il metodo vale più dei miei numeri. Per ogni gradino: quanto costa farlo, che cosa togli in costo ricorrente, in quanti mesi rientri. Se non sai rispondere alla terza domanda, non cominciare.
CQRS, event sourcing, microservizi e MediatR: che differenza c'è?
Quattro parole che nelle riunioni si usano come sinonimi e che invece indicano quattro decisioni separate. Metterle in fila evita di comprare quattro cose quando ne serviva una.
- CQRS è una scelta di modello: scrittura e lettura separate. Puoi farla dentro un solo programma con un solo database.
- Event sourcing è una scelta di memorizzazione: salvi la storia dei cambiamenti e ricostruisci lo stato rileggendoli. Si abbina bene a CQRS perché le proiezioni nascono dagli eventi, ma non è obbligatorio, e CQRS funziona benissimo con uno stato normale.
- Microservizi sono una scelta di distribuzione: più programmi indipendenti che parlano fra loro. Un sistema con CQRS può restare un solo programma per tutta la vita, e spesso è la scelta migliore.
- MediatR e librerie simili sono uno strumento: un intermediario che instrada comandi e interrogazioni al gestore giusto. Comodo per aggiungere comportamenti trasversali (registrazione, validazione, transazioni), ma non è CQRS e non è obbligatorio. Le due interfacce che hai visto sopra fanno lo stesso lavoro in dieci righe.
Il motivo per cui la confusione costa è che i preventivi tendono a mettere tutto insieme. Un fornitore ti propone "una moderna architettura a microservizi con CQRS ed event sourcing" per sostituire un gestionale che ha un elenco lento. Non è una proposta tecnica: è un'estensione del perimetro.
Quando ricevi un preventivo del genere, fai una domanda sola per ogni parola: quale problema misurato risolve questa e che cosa costa? Se la risposta è "è la best practice", hai trovato la voce da togliere.
Se stai valutando anche come scegliere fra tecnologie web .NET, trovi il confronto nell'articolo su ASP.NET Core e gli altri framework web. Se invece il tuo gestionale è ancora su una base vecchia, la strada è spesso una migrazione graduale: ne parlo in migrazione di applicazioni WebForms, WPF e MVC verso Blazor.
Quali errori evitare quando si adotta il pattern CQRS?
Gli errori che vedo più spesso, e che costano di più, sono otto.
- Cominciare dal database separato. È il gradino più caro e quello con più rischi. Si arriva al 2 passando dallo 0 e dall'1, e solo se i numeri lo chiedono.
- Applicarlo a tutto il sistema. CQRS si usa dove il modello unico fa male, tipicamente su due o tre aree. L'anagrafica dei fornitori, un'area di configurazione, una tabella di decodifica non ne hanno bisogno. Un sistema con CQRS ovunque ha dieci volte le classi che servono.
- Sottovalutare il ritardo. Se usi un database di lettura separato, qualcuno prima o poi leggerà dati vecchi di un secondo e deciderà di conseguenza. Decidi in anticipo quali schermate possono tollerarlo e quali devono leggere dal database di scrittura.
- Dimenticare di ricostruire. Un modello di lettura è una copia, e le copie si corrompono. Serve una procedura che lo rifà da zero partendo dalla fonte, provata almeno una volta prima di averne bisogno.
- Far restituire dati ai comandi. Un comando che torna l'ordine completo rimette insieme proprio quello che avevi separato. Restituisci l'identificativo, o al massimo l'esito.
- Mettere logica nelle letture. Se la query dell'elenco decide che un ordine è "in ritardo" con una regola sua, quella regola esiste in due posti. Le regole di business stanno nel modello di scrittura; la lettura le mostra.
- Non misurare prima. Senza il tempo di una lettura e il costo di una modifica prima del progetto, non puoi dire dopo se è servito. Due fogli bastano: i numeri di oggi e i numeri fra sei mesi.
- Affidarlo a chi non ha mai tenuto un sistema in produzione. La differenza fra un esempio che compila e un sistema che regge sta nelle domande sul malfunzionamento: cosa succede se il processo si ferma, se un messaggio arriva due volte, se il database di lettura è fuori linea. Chi non le ha mai viste dal vivo le scopre a tue spese.
C'è una regola che metto prima di tutte le altre e la scrivo in grande: ogni livello di separazione che aggiungi lo paghi per sempre. Costa nel primo progetto, nella manutenzione, nell'ingresso di ogni nuova persona del team. Prima di salire un gradino, assicurati di sapere cosa guadagni in euro, non in eleganza.
Come si introduce CQRS in un gestionale che è già in produzione?
Nessuno può fermare un gestionale per tre mesi e riscriverlo. Per fortuna non serve: CQRS si introduce un'operazione alla volta, mentre il sistema continua a lavorare, e ogni passo si può annullare.
Il metodo che uso ha una regola sola: si comincia dall'operazione che costa più cara, non da quella più semplice. Nel nostro caso è l'elenco degli ordini aperti, cioè la lettura che genera più richieste di modifica e più lamentele.
Ecco il piano in novanta giorni che ho visto funzionare.
- Giorni 1-10: i numeri. Compila la tabella dell'azienda tipo con i tuoi dati. Conta scritture, letture, tempi, richieste di modifica. Il risultato è il rapporto che decide da dove partire.
- Giorni 11-20: le cure di base. Indici sulle colonne di filtro, proiezioni al posto del caricamento delle entità intere, lettura senza tracciamento, isolamento a istantanea. Rimisura. Se il sintomo è sparito e le modifiche non costano troppo, fermati qui.
- Giorni 21-40: il gradino 0 sulla lettura peggiore. Prendi l'elenco più contestato e spostalo in una classe di interrogazione. Poi prendi il comando più usato (di solito la creazione dell'ordine) e fai lo stesso. Il resto del sistema non cambia.
- Giorni 41-60: i test. Scrivi test di integrazione sul comando e sull'interrogazione che hai separato, sul database vero e non su uno finto. Sono la rete di sicurezza per tutto quello che viene dopo.
- Giorni 61-80: il gradino 1, solo se serve. Se dopo il gradino 0 l'elenco è ancora lento o le modifiche costano ancora troppo, crea la tabella di lettura e la procedura che la ricostruisce da zero. Prova la ricostruzione prima di metterla in produzione.
- Giorni 81-90: la misura. Rifai il conteggio dei tempi e delle giornate per modifica. Confronta con la stima. Se il ritorno è sotto la metà di quanto previsto, capisci perché prima di passare a un'altra area.
Ci sono tre accorgimenti che fanno la differenza fra un passaggio indolore e un mese di emergenze.
- Convivenza. Per un periodo il vecchio codice e il nuovo fanno la stessa cosa. Una lettura viene servita dal nuovo percorso per il 10 per cento degli utenti, poi per il 50, poi per tutti. Se qualcosa non torna, torni indietro cambiando un'impostazione.
- Confronto automatico. Nei primi giorni esegui entrambe le letture e confronta i risultati in un registro. Le differenze ti dicono dove il modello di lettura ha perso un caso (un ordine annullato, uno spostato) prima che lo scopra un cliente.
- Un'area alla volta. Dopo la prima area, ferma tutto per quattro settimane e usala. Il secondo progetto parte con una squadra che ha già commesso gli errori del primo, e costa meno.
Questo approccio è lento solo in apparenza. Un progetto "grande" che riscrive tutto in sei mesi ha una probabilità alta di arrivare in ritardo, fuori budget e con regole di business perse per strada. Un progetto per aree consegna valore dal primo mese e ti lascia scegliere, a ogni passo, se continuare.
E c'è un vantaggio che i preventivi non mostrano: durante tutto il percorso hai un sistema funzionante. Gli operatori continuano a inserire ordini, l'amministrazione continua a fatturare, e chi ti ha chiesto la nuova colonna nell'elenco la riceve in due giorni invece che in due settimane.
E se il numero dice che non è il tuo problema?
Succede spesso, ed è una buona notizia. Se il rapporto fra letture e scritture è sotto il 10 a 1 e hai meno di tre forme di lettura, un progetto CQRS non si ripaga. Il collo di bottiglia, se c'è, sta quasi sempre altrove.
Se una schermata è lenta, controlla prima l'indice. Metà delle query lente che vedo nei gestionali sono lente perché manca un indice su una colonna di filtro o perché la query carica l'entità intera con le sue relazioni invece di una proiezione. Un'ora di lavoro, non quaranta giornate.
Se le scritture si bloccano durante i report, prima di tutto abilita l'isolamento a istantanea. È un'impostazione del database, la provi in un pomeriggio e spesso fa sparire il problema.
Se il codice è un groviglio, con regole nelle schermate e nelle query, CQRS non lo ordina: lo moltiplica. Si comincia dal portare le regole nel modello di scrittura e dal coprire con test le operazioni critiche. Poi, e solo poi, si separa.
Se il team ha due persone e un solo sistema, un gradino 0 ben fatto vale più di un gradino 2 fatto a metà. La complessità si paga in attenzione, e due persone ne hanno poca.
E c'è un caso in cui il pattern non è la risposta nemmeno con numeri brutti: quando il sistema è sbagliato da capo, cioè regge un processo che non esiste più. Lì il lavoro non è architettonico, è chiedersi cosa serve davvero all'azienda. Una modernizzazione ben fatta vale più di qualunque pattern.
Se sei arrivato fin qui, probabilmente hai in mente il tuo martedì alle dieci. Prima di aprire qualunque preventivo, prendi i tuoi numeri: scritture e letture al giorno, tempo di una lettura lenta e di una scrittura sotto carico, richieste di modifica dell'ultimo anno e giornate che sono costate. Mezza giornata di lavoro.
Se il rapporto supera il 10 a 1 e hai almeno tre forme di lettura, hai già la risposta sul primo gradino. Se supera il 100 a 1, o se le cure di base non bastano, vale la pena guardare il secondo. Il resto è un progetto, non una scelta di moda.
Se vuoi un secondo sguardo sul tuo caso, la strada è la consulenza software. E quando la soluzione giusta è un gestionale costruito attorno al tuo modo di lavorare, con modelli che reggono le modifiche per i prossimi dieci anni, lo trovi spiegato nella pagina sul software su misura.
Domande frequenti
È la separazione fra il codice che cambia i dati (comandi) e il codice che li mostra (interrogazioni), con modelli diversi: uno piccolo e rigoroso per scrivere, uno piatto e veloce per leggere. Non è event sourcing, non sono i microservizi e non richiede due database: si può fare dentro un solo programma con un solo database.
Quando il rapporto fra letture e scritture supera circa 10 a 1 e hai almeno tre forme diverse di lettura. Sotto quella soglia bastano indici e query ben scritte. Sopra 100 a 1, o con letture che disturbano le scritture anche dopo le cure di base, può servire un database di lettura separato.
Per un gestionale di una PMI, ordini di grandezza: 1.440 euro per le cure di base, 3.840 per separare comandi e query nel codice, 7.680 per i modelli di lettura sullo stesso database, circa 17.760 il primo anno per un database di lettura separato. Sono costi a 480 euro a giornata e non preventivi.
No. Il database separato è un gradino possibile, non il punto di partenza, e l'event sourcing è una decisione indipendente che costa molto di più. Per la maggior parte delle aziende bastano i primi due gradini: comandi e query separati nel codice e modelli di lettura sullo stesso database.
Spesso sì, come effetto collaterale, perché una lettura piatta e indicizzata è più veloce di nove join. Ma il motivo vero è un altro: ridurre il costo delle modifiche. Se il problema è solo una query lenta, un indice o una proiezione costano un decimo e vanno provati prima.
Con un database di lettura separato i dati arrivano con un piccolo ritardo, di solito un secondo. Va bene per un elenco ordini, non va bene per controllare la disponibilità di magazzino prima di confermare una vendita. Si decide in anticipo quali letture possono tollerarlo.
Lascia i tuoi dati nel form qui sotto