Si può rifattorizzare codice legacy con l'intelligenza artificiale?
Il responsabile IT di un'azienda di logistica del Veneto mi ha scritto così: "Abbiamo un gestionale in C# di 80.000 righe, scritto in dieci anni da sei persone diverse, senza un solo test. Un nostro sviluppatore dice che con l'intelligenza artificiale lo sistema in un mese. Un altro dice che ce lo rompe in una settimana. Chi ha ragione?".
Hanno ragione tutti e due, e dipende da come si usa. Dopo anni a modernizzare sistemi che girano da quindici o vent'anni, ho stimato dove l'AI fa risparmiare tempo vero e dove produce codice che sembra giusto e non lo è. Il refactoring di codice legacy con intelligenza artificiale, fatto con metodo, riduce il lavoro del 30-35% rispetto a farlo a mano. Fatto senza metodo, lo trasforma in un problema nuovo, più difficile da trovare perché il codice generato è ordinato e convincente.
In questa guida trovi che cosa significa davvero rifattorizzare con l'AI, dove l'AI accelera, dove sbaglia (con un caso reale di arrotondamento), perché prima dei test non si tocca niente, il metodo in sei passi che uso, come dare il contesto giusto all'assistente, un esempio completo con il codice prima e dopo, gli strumenti, la riservatezza del codice, i costi con una tabella, i casi in cui conviene non usarla e gli errori che vedo ripetersi. In fondo c'è una regola in cinque righe per decidere.
Scrivo software dal 1999 e mi occupo di modernizzare sistemi aziendali senza fermare chi ci lavora. Se la domanda a monte è se rifattorizzare o riscrivere, parti da riscrivere o rifattorizzare il software legacy: l'AI cambia i costi, non la logica della scelta. Per il quadro completo del metodo vedi la modernizzazione del software legacy.
Che cosa significa fare refactoring di codice legacy con l'intelligenza artificiale?
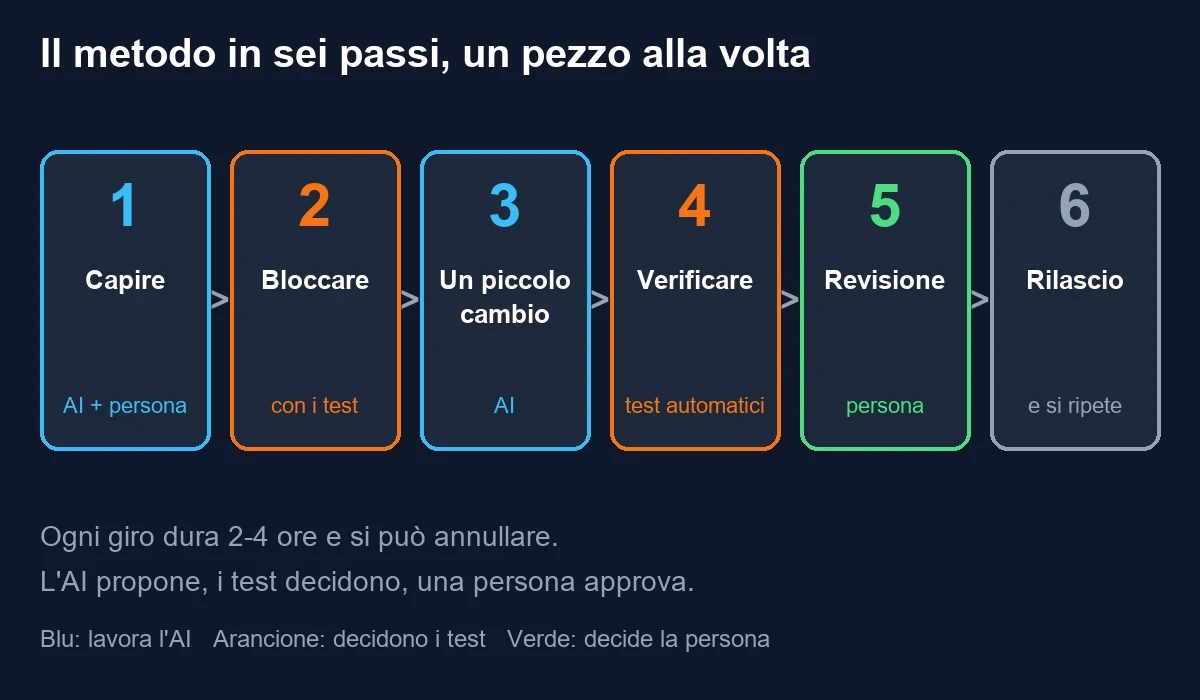
Significa usare un assistente AI per leggere, spiegare, testare e riscrivere a piccoli passi codice che funziona e che nessuno osa toccare, mantenendo identico il comportamento osservabile. L'AI propone, i test decidono, una persona approva.
Il refactoring è la modifica della struttura interna del codice senza cambiarne il comportamento visibile dall'esterno. Per definizione, dopo un refactoring l'applicazione fa le stesse cose di prima, con gli stessi risultati, negli stessi tempi o meglio. Non è una funzione nuova e non è una riscrittura: è mettere ordine in una stanza senza spostare i mobili che servono.
Il codice legacy, in questo contesto, non è "vecchio". È codice che non ha test, che nessuno spiega più per intero e che si ha paura di modificare. Può avere due anni o vent'anni. Quello che lo rende legacy è l'assenza di una rete di sicurezza. Per questo il primo lavoro non è riscrivere: è costruire la rete.
Che cosa fa l'AI in questo lavoro
Un assistente di intelligenza artificiale per il codice è un modello linguistico che legge sorgenti, li riassume, li confronta, propone modifiche e scrive test. Sa moltissimo di C#, di .NET e dei modi più comuni in cui il codice viene scritto. Non sa niente del tuo database reale, delle regole di business che nessuno ha mai scritto e delle abitudini dei tuoi clienti. Legge quello che c'è, non quello che manca.
Che cosa non è
Non è un pulsante "modernizza". Non trasforma un VB6 in un'applicazione .NET 10 in un pomeriggio, e chi lo promette sta vendendo un sogno. Non sostituisce chi conosce il dominio. E non è un motivo per saltare i test: è il motivo per cui i test diventano più importanti, perché il codice cambia più in fretta e più in profondità di prima.
Perché oggi se ne parla tanto
Perché il costo di una cosa che prima era lenta è crollato: leggere 3.000 righe di un modulo sconosciuto e scrivere un riassunto che regge. Un tempo erano due giorni di una persona senior. Oggi sono venti minuti, più un'ora per verificare. Quel risparmio è reale. Il rischio è confondere la velocità di scrittura con la correttezza del risultato, ed è lì che si fanno i danni.
Dove l'AI accelera davvero il refactoring del codice legacy?
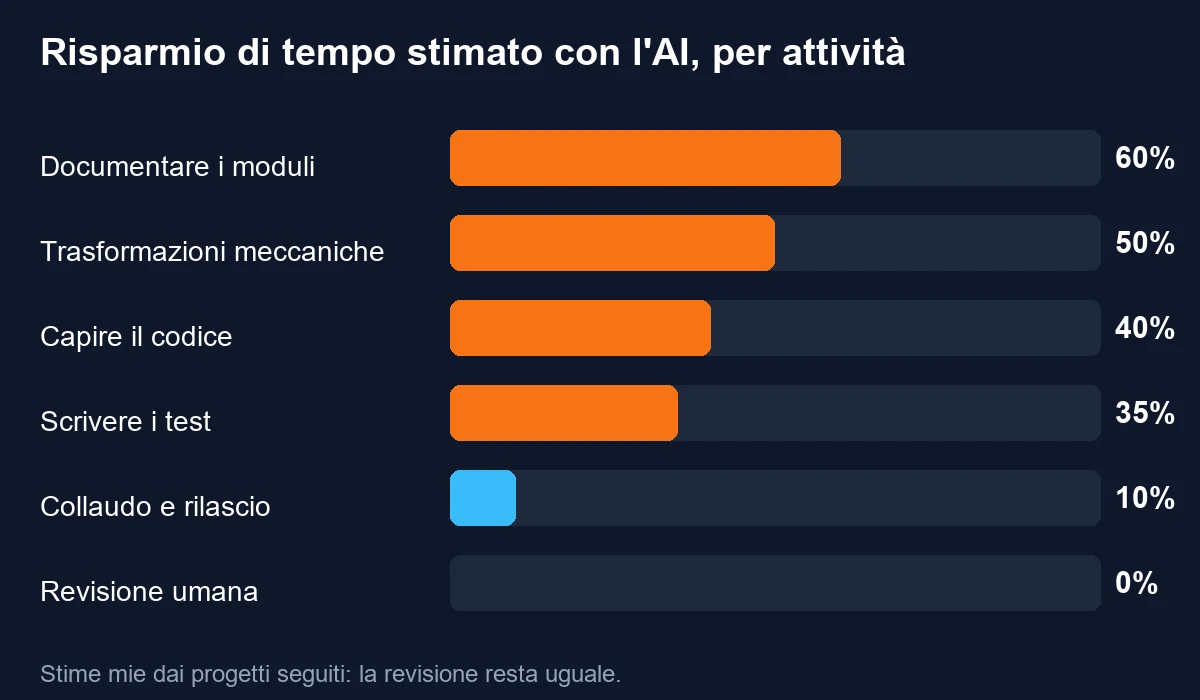
Accelera cinque attività: capire codice che non conosci, documentarlo, scrivere test di partenza, eseguire trasformazioni meccaniche ripetitive e proporre struttura. Sono lavori lunghi, noiosi e verificabili, ed è per questo che l'AI li fa bene.
1. Capire codice che non hai scritto
È il risparmio più grande. Un metodo da 400 righe con nomi di variabili come x1, tmp2 e flag richiede mezza giornata per essere compreso da una persona. Un assistente lo legge in pochi secondi, ne descrive il flusso, elenca i rami, segnala le condizioni che non si verificano mai e le dipendenze nascoste (lettura di una variabile globale, scrittura su file, orologio di sistema). Non devi fidarti: devi usarlo come una prima ipotesi che poi controlli. Ma partire da un'ipotesi scritta fa risparmiare molto rispetto a partire dal foglio bianco.
2. Documentare quello che c'è
Il legacy è spesso privo di documentazione, e la documentazione che c'è è sbagliata. L'AI scrive commenti, descrizioni dei moduli e diagrammi dei flussi a partire dal codice, in italiano e in inglese. È il lavoro che nessuno vuole fare e che serve a chi arriva dopo. Il risparmio stimato è intorno al 60%, perché resta da fare solo la lettura critica. Una documentazione generata e poi corretta da chi conosce il dominio vale più di una scritta a mano e mai finita.
3. Scrivere test di partenza
Dato un metodo, l'AI propone casi di prova: i valori limite, i rami meno ovvi, i dati vuoti, i numeri negativi. Questi test non sono ancora quelli giusti, perché descrivono quello che il codice potrebbe fare, non quello che fa. Ma sono una buona base da cui partire per i test di caratterizzazione di cui parlo più avanti. Risparmio tipico: 35%.
4. Trasformazioni meccaniche ripetitive
Rinominare, estrarre un metodo, sostituire un ciclo con una query LINQ, convertire ArrayList in List<T>, passare da string.Format a stringhe interpolate, aggiungere i tipi nullable, convertire le chiamate sincrone in asincrone dove il framework lo consente. Sono centinaia di modifiche tutte uguali. L'AI le fa in serie, un file alla volta, e il compilatore con i test controllano il risultato. Qui il risparmio arriva al 50%.
5. Proporre una struttura
Davanti a una classe di 3.000 righe, l'assistente suggerisce come spezzarla: quali responsabilità distinte contiene, quali metodi appartengono insieme, quali dipendenze vanno invertite. Non è una decisione da accettare alla cieca, ma è un buon punto di discussione. Se vuoi capire la direzione, la descrivo in Clean Architecture in .NET: quando serve e quando è over-engineering.
Dove il risparmio è zero
Nella revisione. Ogni riga generata va letta da una persona che capisce il dominio, e leggere codice richiede lo stesso tempo di prima: anzi, di più, perché c'è molto più codice da leggere nello stesso tempo. Chi dichiara un risparmio dell'80% sull'intero lavoro sta quasi sempre saltando la revisione. Ed è il passaggio che impedisce i danni.
Dove l'AI sbaglia quando tocca codice legacy?
Sbaglia dove il comportamento dipende da regole che non sono scritte: arrotondamenti, ordine delle operazioni, formati di data, concorrenza, effetti collaterali. Il codice che produce è pulito e plausibile, ed è proprio per questo che l'errore passa.
Le regole che non sono nel codice
Un caso tipico, semplificato. Un gestionale calcola lo sconto su un ordine e arrotonda il risultato con Math.Round(prezzo, 2). In .NET, quella funzione usa per default l'arrotondamento al pari più vicino (detto "bancario"): 2,125 diventa 2,12 e 2,135 diventa 2,14. L'assistente, rifattorizzando, ha riscritto la riga con MidpointRounding.AwayFromZero, quello che a scuola si impara per primo, perché "è più corretto". Il risultato: centesimi diversi su una piccola parte degli ordini, e dopo un mese un cliente che contesta la fattura e una contabilità che non torna più con l'archivio. Il codice nuovo era più "giusto". Era anche diverso.
L'ordine delle operazioni
Sconto in percentuale e poi fisso, oppure il contrario: il risultato cambia. Un assistente che "semplifica" una sequenza di if può cambiare l'ordine senza accorgersene, perché a livello logico le due scritture sembrano equivalenti. Non lo sono quando ci sono arrotondamenti intermedi o soglie.
Date, fusi orari e culture
Il legacy è pieno di DateTime.Now, di conversioni con la cultura corrente del server e di date salvate come testo. Modernizzare questi punti senza guardare chi li usa è un campo minato: un'applicazione che oggi funziona perché il server è in fuso italiano smette di funzionare quando passa a un hosting in un altro fuso. L'AI propone DateTimeOffset e TimeProvider (giustamente) e non sa che tre report esterni leggono quelle stringhe.
Effetti collaterali nascosti
Un metodo chiamato Leggi che nel passato ha cominciato anche a scrivere un file di log, a bloccare una riga o ad aggiornare una cache. L'assistente lo vede come una lettura e lo riorganizza come tale. Il comportamento nascosto sparisce, e con lui la cosa su cui un altro processo contava.
Concorrenza e transazioni
Dove c'è un blocco sul database, una transazione che copre più chiamate o una variabile statica condivisa fra richieste, l'AI tende a produrre codice corretto per un utente e sbagliato per cinquanta. I problemi di concorrenza non si vedono in una prova a mano. Si vedono il lunedì mattina alle nove.
Le "allucinazioni"
Succede anche questo: l'assistente inventa un metodo che non esiste nella libreria, o usa un'opzione di una versione diversa. Questo errore è il meno pericoloso, perché il compilatore lo ferma subito. Come nascono e come si riducono lo spiego in allucinazioni nell'AI e come ridurle con la RAG. Gli errori che costano sono gli altri: quelli che compilano, passano la prova veloce e cambiano un numero.
Il filo comune
Tutti questi errori hanno una caratteristica: il codice nuovo è migliore di quello vecchio secondo un criterio generale, ed è diverso secondo il criterio che conta, cioè "fa quello che faceva". Nessun assistente può saperlo senza un riferimento. Il riferimento sono i test.
Perché prima di rifattorizzare con l'AI servono i test di caratterizzazione?
Perché sono l'unico modo di sapere se il comportamento è rimasto uguale. Un test di caratterizzazione non dice cosa il codice dovrebbe fare: registra cosa fa oggi, e segnala ogni differenza dopo la modifica.
Il test di caratterizzazione (in inglese characterization test o golden master) è una tecnica descritta da Michael Feathers nel suo libro sul codice legacy. Si prende il codice com'è, lo si fa girare con un insieme di ingressi realistici e si salvano le uscite. Quelle uscite diventano il riferimento: non perché siano giuste, ma perché sono quelle che gli utenti vedono oggi. Dopo ogni modifica si rilanciano gli stessi ingressi e si confrontano le uscite. Se coincidono, il comportamento è rimasto uguale. Se no, c'è qualcosa da capire.
Dove prendere gli ingressi
Il materiale migliore sono i dati veri: un campione di ordini, fatture o righe di produzione degli ultimi mesi, ripulito dai dati personali. Altrimenti si costruiscono casi a mano sui valori limite. Le trecento righe più strane valgono più di tremila righe normali: contengono i casi per cui qualcuno, nel 2014, ha scritto quell'if che adesso nessuno capisce.
Un esempio completo
Il test qui sotto legge da una cartella coppie di file (un ingresso in formato JSON e il risultato atteso in testo) e li confronta con quello che restituisce il metodo da rifattorizzare. Per aggiungere un caso basta aggiungere due file, senza toccare il codice.
// Test di caratterizzazione con xUnit su .NET 10 (ImplicitUsings attivi).
// Ogni coppia di file in /Golden è un caso: nome.input.json e nome.atteso.txt.
using System.Globalization;
using System.Text.Json;
using Xunit;

public class CalcoloScontoCaratterizzazione
{
    private static readonly string Cartella =
        Path.Combine(AppContext.BaseDirectory, "Golden");

    public static IEnumerable<object[]> Casi()
    {
        foreach (var file in Directory.GetFiles(Cartella, "*.input.json"))
        {
            var nome = Path.GetFileName(file).Replace(".input.json", "");
            yield return new object[] { nome };
        }
    }

    [Theory]
    [MemberData(nameof(Casi))]
    public void Il_risultato_non_cambia(string nome)
    {
        var json = File.ReadAllText(Path.Combine(Cartella, nome + ".input.json"));
        var riga = JsonSerializer.Deserialize<RigaOrdine>(json)!;
        var atteso = File.ReadAllText(Path.Combine(Cartella, nome + ".atteso.txt")).Trim();

        var reale = CalcolatoreSconti.Calcola(riga)
            .ToString("F2", CultureInfo.InvariantCulture);

        Assert.Equal(atteso, reale);
    }
}
I file con i risultati attesi si generano la prima volta lanciando il codice vecchio, non scrivendoli a mano. È la differenza fra "cosa dovrebbe fare" e "cosa fa". Se un risultato ti sembra sbagliato, annotalo come anomalia da discutere con chi usa il programma, ma non correggerlo durante il refactoring: una cosa alla volta.
Quanti test bastano
Non cerco la copertura del 100%. Cerco la copertura dei punti che cambierò: per ogni metodo da toccare, abbastanza casi da far scattare ogni ramo e ogni soglia, di norma da venti a cento ingressi. Per un modulo di calcolo, una mattinata di lavoro. Per un'intera applicazione, i test di caratterizzazione sulle trenta funzioni più importanti coprono la maggior parte del rischio.
L'AI aiuta a scrivere anche questi
Qui l'assistente è molto utile: legge il metodo, elenca i rami e genera gli ingressi che li attraversano tutti, compresi i valori sulle soglie (49, 50, 51 per uno scaglione da 50). Poi si eseguono sul codice vecchio e si salvano le uscite. L'AI propone gli ingressi; è l'esecuzione sul codice vecchio a stabilire le risposte giuste. Non si chiede mai all'assistente di indovinare il risultato atteso.
Qual è il metodo in sei passi per rifattorizzare codice legacy con l'AI?
Il metodo è: capire, bloccare il comportamento con i test, fare un piccolo cambio, verificare, far rivedere da una persona, rilasciare e ripetere. Ogni giro dura ore, non settimane, e ogni giro si può annullare.
Passo 1: capire
Si sceglie un pezzo piccolo, per esempio un metodo o una classe, e si chiede all'assistente di descriverlo: che cosa fa, quali dati legge e scrive, quali condizioni hanno effetto, quali parti sembrano morte. Una persona che conosce il dominio legge la descrizione e la corregge. Non si va avanti finché la descrizione non coincide con quello che la persona sa del programma.
Passo 2: bloccare il comportamento
Si scrivono i test di caratterizzazione per quel pezzo, come nel paragrafo precedente. Si eseguono sul codice vecchio e devono essere verdi. Se il pezzo dipende da cose difficili da isolare (database, orologio, file), si introduce prima una cucitura minima: un'interfaccia o un parametro in più, senza cambiare nient'altro. È il solo cambiamento permesso prima dei test, ed è piccolo e controllabile.
Passo 3: un piccolo cambio alla volta
Si chiede all'assistente una sola trasformazione, per esempio "estrai il calcolo dello scaglione in un metodo privato" oppure "sostituisci questo ciclo con una tabella di soglie". Non "pulisci questo file". Una richiesta ampia produce un diff enorme che nessuno legge davvero, e un diff che nessuno legge è una scommessa.
Passo 4: verificare
Si compila e si lanciano i test. Verdi: si va avanti. Rossi: si guarda la differenza, che dice esattamente cosa è cambiato. Quasi sempre è l'assistente ad aver cambiato un comportamento, e si annulla. Qualche volta è stato il test a rivelare un'anomalia del codice vecchio, e allora si decide a parte se correggerla, in un commit distinto.
Passo 5: revisione di una persona
Una persona legge il diff. Non per controllare la sintassi (lo fa il compilatore), ma per rispondere a tre domande: il nome dice quello che fa il codice? Ci sono effetti collaterali che prima c'erano e adesso no? Ho capito perché è fatto così? Se non rispondi sì a tutte e tre, il cambio non entra. Questo passo non si accorcia con l'AI, come detto prima.
Passo 6: rilascio e ripetizione
Il cambio entra in un commit piccolo, con un messaggio che spiega cosa è stato fatto e perché. Si rilascia in un ambiente di prova, poi in produzione secondo il ritmo normale dell'azienda. Quindi si riparte dal passo 1 con il pezzo successivo. In un progetto di 80.000 righe i giri sono qualche centinaio. Se ognuno dura due-quattro ore, ecco da dove vengono i 45-65 giorni persona della tabella sui costi.
Perché funziona
Perché ogni giro è abbastanza piccolo da poter essere annullato e abbastanza verificabile da dimostrare di aver funzionato. È la stessa logica dello strangler fig pattern: sostituire il vecchio un pezzo alla volta, con il sistema sempre in piedi. L'intelligenza artificiale non cambia la strategia, accelera i singoli giri.
Come si dà il contesto giusto a un assistente AI sul codice legacy?
Si dà il pezzo da toccare, le sue dipendenze dirette, le regole di business che conosci e i vincoli non negoziabili. Non l'intero repository: più contesto inutile significa risposte peggiori e un costo più alto.
Il pezzo e le sue dipendenze
Il file o il metodo da modificare, le firme delle classi che usa e i tipi dei dati in ingresso e in uscita. Se il metodo legge una tabella, la definizione della tabella. Un assistente con solo il codice vede metà del problema: con lo schema vede anche cosa significano i campi.
Le regole che conosci
Quello che nel codice non c'è: "gli arrotondamenti devono restare al pari più vicino perché la contabilità li usa", "questa soglia è stata concordata con il cliente nel 2016", "questo metodo viene chiamato anche da un programma esterno via COM". Dieci righe di contesto di questo tipo evitano l'errore più costoso.
I vincoli espliciti
Che cosa non si tocca. Le firme pubbliche, i nomi delle colonne, il formato dei file prodotti, la versione del framework, le librerie permesse. Scritti all'inizio della richiesta, questi vincoli vengono rispettati nella grande maggioranza dei casi; dati per scontati, no.
Un modello di richiesta
Questo è il formato che uso, in forma breve:
Contesto: gestionale ordini in C# su .NET Framework 4.8, il metodo calcola lo sconto di riga. Obiettivo: renderlo leggibile senza cambiare nessun risultato. Vincoli: firma pubblica invariata, arrotondamento al pari più vicino (quello di default di Math.Round), nessuna nuova libreria. Test: la cartella Golden contiene 240 casi, devono restare tutti verdi. Richiesta: estrai il calcolo dello scaglione in un metodo privato e sostituisci la catena di if con una tabella di soglie. Non toccare altro e non cambiare l'ordine delle operazioni.
Una richiesta così produce un diff di venti righe, leggibile in due minuti. Una richiesta tipo "migliora questo codice" produce un diff di duecento righe e una giornata di dubbi.
Quando conviene un agente invece di una chat
Gli agenti da riga di comando, che leggono il repository, eseguono i test e iterano da soli, sono molto più potenti di una chat e anche più pericolosi. Li uso per i passi meccanici su molti file (rinomine, conversioni, correzioni di avvisi del compilatore), sempre su un ramo dedicato, con i test che devono restare verdi a ogni passo e un limite alla dimensione di ogni commit. Per le parti con regole di business, preferisco la chat, un pezzo alla volta.
Come appare un refactoring completo con AI: un esempio prima e dopo?
Il metodo di partenza ha 20 righe di condizioni annidate, quello finale è una tabella di soglie e un calcolo di tre righe. Il risultato è identico, centesimo per centesimo, perché i 240 casi dei test lo dimostrano.
Il codice di partenza
Questo è il tipo di metodo che si trova ovunque: sconti per tipo di cliente, scaglioni di quantità, un bonus fisso per i clienti storici e un minimo a zero. Funziona da dieci anni.
public record Cliente(string Tipo, int Anni);
public record RigaOrdine(int Quantita, decimal PrezzoUnitario, Cliente Cliente);

public static class CalcolatoreSconti
{
    // PRIMA: versione storica, nessun test.
    public static decimal Calcola(RigaOrdine r)
    {
        decimal prezzo = r.Quantita * r.PrezzoUnitario;
        if (r.Cliente.Tipo == "A")
        {
            if (r.Quantita >= 100) prezzo = prezzo * 0.85m;
            else if (r.Quantita >= 50) prezzo = prezzo * 0.90m;
            else prezzo = prezzo * 0.95m;
        }
        else if (r.Cliente.Tipo == "B")
        {
            if (r.Quantita >= 100) prezzo = prezzo * 0.92m;
            else prezzo = prezzo * 0.97m;
        }
        if (r.Cliente.Anni > 5) prezzo = prezzo - 25;
        if (prezzo < 0) prezzo = 0;
        return Math.Round(prezzo, 2);
    }
}
Il codice dopo il refactoring
Dopo i test di caratterizzazione e un paio di giri con l'assistente, la logica diventa una tabella leggibile da chi non programma. Gli scaglioni stanno in due elenchi, e aggiungerne uno nuovo è una riga.
public static class CalcolatoreSconti
{
    // DOPO: stessa firma, stesso risultato, struttura leggibile.
    private static readonly (int Soglia, decimal Fattore)[] ScaglioniA =
        { (100, 0.85m), (50, 0.90m), (0, 0.95m) };

    private static readonly (int Soglia, decimal Fattore)[] ScaglioniB =
        { (100, 0.92m), (0, 0.97m) };

    public static decimal Calcola(RigaOrdine riga)
    {
        var importo = riga.Quantita * riga.PrezzoUnitario;
        importo *= FattoreScaglione(riga.Cliente.Tipo, riga.Quantita);

        if (riga.Cliente.Anni > 5) importo -= 25m;

        // Arrotondamento al pari più vicino mantenuto di proposito:
        // è quello che la contabilità usa da sempre.
        return Math.Round(Math.Max(importo, 0m), 2);
    }

    private static decimal FattoreScaglione(string tipo, int quantita)
    {
        var scaglioni = tipo switch
        {
            "A" => ScaglioniA,
            "B" => ScaglioniB,
            _ => null
        };

        if (scaglioni is null) return 1m;

        foreach (var (soglia, fattore) in scaglioni)
            if (quantita >= soglia) return fattore;

        return 1m;
    }
}
Che cosa ha fatto l'AI e che cosa ho fatto io
L'assistente ha proposto la tabella di soglie e ha scritto la prima versione del metodo. Io ho scritto (o fatto scrivere e poi controllato) i 240 casi di prova, ho deciso di mantenere l'arrotondamento storico e ho aggiunto il commento che spiega perché. È un errore tipico: se l'assistente propone MidpointRounding.AwayFromZero, i test diventano rossi sui casi con mezzo centesimo, ed è così che si vede. Senza la cartella di prova, quella modifica entra in produzione.
Il valore del commento
Il commento che spiega l'arrotondamento è la parte più preziosa del risultato. Quella conoscenza stava nella testa di una persona e in nessun altro posto. Rifattorizzare bene significa anche questo: trasformare ciò che si sa a voce in qualcosa che sta nel codice e che il prossimo sviluppatore (o il prossimo assistente) trova leggendo.
E se fossero 80.000 righe?
Questo è un metodo. In un sistema vero se ne rifattorizzano centinaia, e la parte che conta non è la singola trasformazione ma l'ordine: si parte da dove si cambia più spesso e dove i test sono più facili da scrivere, non dal codice più brutto. Un modulo orribile che nessuno tocca da cinque anni può aspettare, e spesso la risposta giusta per quel modulo è lasciarlo com'è.
Quali strumenti conviene usare per il refactoring con intelligenza artificiale?
Conviene un assistente integrato nell'editor per i piccoli passi, un agente da riga di comando per le trasformazioni di massa e, per i dati sensibili, un modello che gira in un ambiente controllato. Lo strumento conta meno del metodo.
Assistenti nell'editor
Visual Studio e gli altri editor hanno assistenti integrati che completano il codice, spiegano un metodo e propongono refactoring a partire da una selezione. Sono comodi per i passi 1 e 3 del metodo: pezzo piccolo, risposta immediata, controllo visivo sul diff. Hanno però poco contesto del resto del progetto e si fidano di quello che vedono.
Agenti da riga di comando
Leggono tutto il repository, eseguono i comandi, compilano e lanciano i test da soli. Sono la scelta giusta per le operazioni di massa e per scrivere test su molti file. Il prezzo è il rischio: un agente può fare cento modifiche in cinque minuti, e se i test non coprono il comportamento, cento modifiche sbagliate. Per questo ogni sessione di lavoro va su un ramo separato, con commit piccoli e un controllo umano prima di ogni integrazione.
Modelli in ambiente controllato
Quando il codice contiene dati o logiche riservate, si può usare un modello ospitato in un ambiente che l'azienda controlla, oppure un servizio con contratto che esclude l'uso dei dati per l'addestramento. È una scelta di governo prima che tecnica, e la affronto nel paragrafo sulla riservatezza. Per una regola aziendale su come usare questi strumenti vedi vibe coding in azienda: policy e governance e l'adozione dell'AI nel team di sviluppo.
Strumenti non AI che restano indispensabili
Il compilatore con gli analizzatori attivi, gli strumenti di analisi statica, il controllo delle dipendenze vulnerabili, un sistema di integrazione continua che lancia i test a ogni commit. Sono quelli che catturano il 90% dei problemi in modo deterministico, senza costi e senza interpretazioni. L'AI si aggiunge a questi, non li sostituisce.
Come scelgo
Parto sempre dal problema, non dallo strumento. Se ho cinquanta classi da spostare in un nuovo namespace, un agente. Se ho un metodo contorto da capire, la chat con il contesto giusto. Se ho codice che non può uscire dall'azienda, un ambiente controllato o niente AI. E in tutti i casi, i test prima.
Il codice aziendale è al sicuro quando lo leggono gli assistenti AI?
Dipende dal servizio e dal contratto, non dalla tecnologia. Prima di usare un assistente su codice aziendale si decide cosa può uscire, dove viene elaborato e se viene conservato o usato per addestrare altri modelli.
Le tre domande da fare al fornitore
Dove viene elaborato il codice, cioè in quale paese e su quale infrastruttura. Per quanto tempo viene conservato. Se viene usato per addestrare o migliorare i modelli. I servizi professionali rispondono per iscritto, con un contratto e con la possibilità di escludere l'addestramento. I servizi gratuiti per consumatori spesso no.
Che cosa non deve uscire mai
Chiavi, password, stringhe di connessione, certificati e dati personali reali. Nel legacy è frequente trovarli scritti nel codice o in file di configurazione dentro il repository. Prima di usare qualsiasi assistente si fa una scansione dei segreti e si spostano dove devono stare. È un lavoro utile in ogni caso, e un buon motivo per cominciare.
Proprietà del codice
Il codice che l'assistente produce è, nei contratti seri, del cliente che lo ha richiesto. Va verificato per ogni servizio e deve stare scritto nel contratto con chi ti sviluppa il software. Un'altra verifica da fare è la presenza di porzioni copiate da progetti con licenze restrittive: gli strumenti professionali offrono filtri, ma una revisione resta necessaria.
La regola semplice
Una regola semplice che funziona: si scrive su un foglio quali cartelle del codice possono essere inviate a un servizio esterno e quali no. Le funzioni di calcolo e di struttura di solito sì. Le parti che contengono dati dei clienti, algoritmi che sono il vantaggio competitivo dell'azienda o credenziali, no. Il resto si discute. Se il tema è più ampio e riguarda l'uso dell'AI nell'impresa, ne parlo in AI nelle PMI: governare il software senza riscriverlo e in intelligenza artificiale per le aziende.
Quanto costa il refactoring di un software legacy con l'AI?
Un gestionale C# da circa 80.000 righe, senza test, costa 27.000-39.000 euro con l'AI usata con metodo, contro 42.000-57.000 euro a mano. Il risparmio è del 30-35%, e arriva da comprensione, documentazione, test e trasformazioni, non dalla revisione.
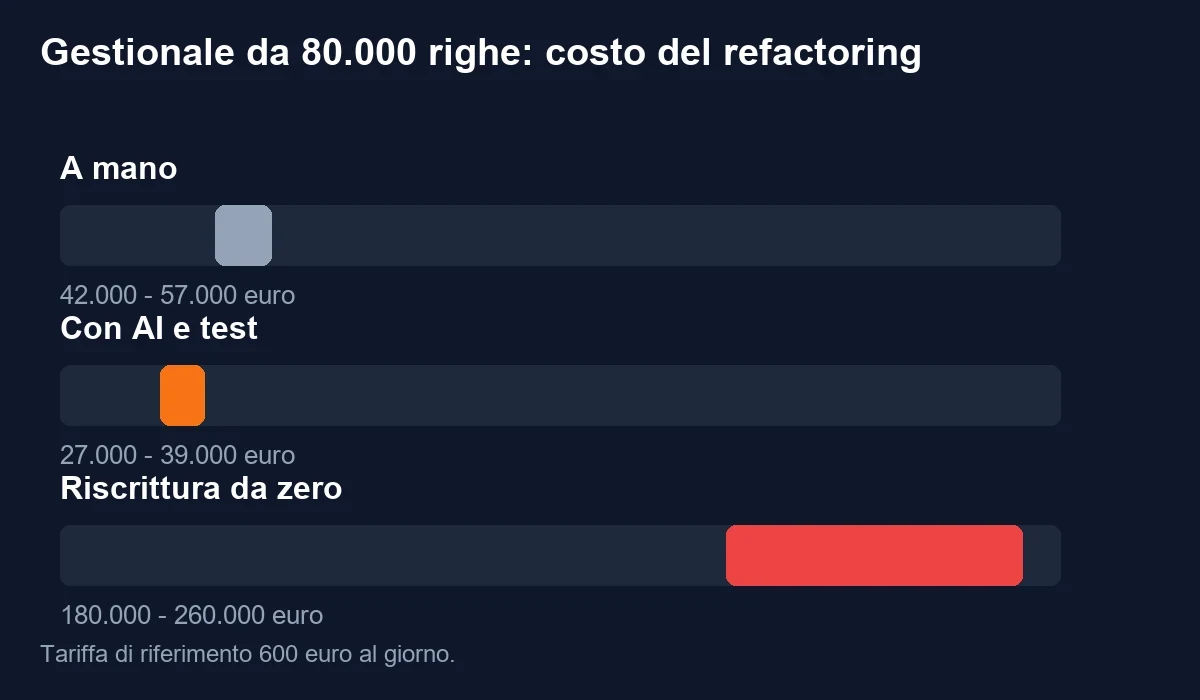
Sono stime mie, ricavate dai progetti che ho seguito e da un caso di riferimento: un gestionale in C# su .NET Framework da circa 80.000 righe, dodici moduli, senza test, con una tariffa di riferimento di 600 euro al giorno. Non sono misure di laboratorio e ogni progetto cambia, ma l'ordine di grandezza regge.
| Attività | A mano (giorni persona) | Con AI e test (giorni persona) |
|---|---|---|
| Inventario e comprensione del codice | 10-14 | 6-9 |
| Documentazione dei moduli | 6-8 | 2-3 |
| Test di caratterizzazione sulle funzioni chiave | 12-16 | 8-11 |
| Trasformazioni e refactoring del codice | 28-37 | 16-24 |
| Revisione, collaudo e rilascio a gradi | 14-20 | 13-18 |
| Totale | 70-95 | 45-65 |
| Costo a 600 euro al giorno | 42.000-57.000 euro | 27.000-39.000 euro |
Che cosa risparmi e che cosa no
Il risparmio sta nelle prime quattro righe. La riga della revisione e del collaudo resta quasi uguale, e a volte sale, perché c'è più codice da leggere nello stesso tempo. Se in un preventivo vedi un taglio del 70% anche su quella riga, nel progetto manca la revisione.
Il costo di non avere i test
C'è una terza colonna che non sta in tabella: l'AI usata senza test costa meno all'inizio, circa 20.000 euro per lo stesso progetto, e poi ti presenta il conto. Un errore di arrotondamento scoperto da un cliente costa tre persone per una settimana. Un cambio nella concorrenza scoperto sotto carico costa un fermo. Il preventivo apparentemente più basso è quasi sempre quello che non ha messo nel conto i test e la revisione.
Come si arriva a un numero per il tuo software
Servono cinque dati: righe di codice, numero di moduli, presenza di test, quanto spesso il codice cambia e chi lo conosce. Con quelli si stima in mezz'ora il perimetro, e si decide quale parte conviene rifattorizzare e quale lasciare. Per i costi complessivi di tenere in piedi un sistema vecchio, vedi quanto costa davvero il software legacy.
Il confronto con la riscrittura
Riscrivere lo stesso gestionale da zero costa tra 180.000 e 260.000 euro e richiede almeno nove mesi senza nuove funzioni, con il rischio di perdere le regole che il vecchio codice contiene. Anche con l'AI, che accorcia la scrittura ma non la scoperta delle regole. Per questo il refactoring a piccoli passi, con una rete di test, resta quasi sempre la scelta con il rischio più basso.
Quando non conviene usare l'intelligenza artificiale per il refactoring?
Non conviene quando il codice non si può far uscire, quando non si riescono a scrivere i test, quando il sistema è troppo piccolo per ripagare il lavoro o quando il problema non è la struttura del codice ma il modello dei dati.
Codice che non può uscire
Se il contratto con un cliente o una norma vieta di inviare il sorgente a servizi esterni, e non c'è un ambiente controllato disponibile, l'AI non si usa. Si lavora a mano, o si usa un modello locale più piccolo per i compiti semplici.
Quando non si riescono a scrivere i test
Codice che dipende da hardware, da macchine industriali o da integrazioni che non si possono simulare è difficile da proteggere con i test automatici. In quei casi si procede con passi ancora più piccoli, verifiche manuali scritte e prove su un impianto di collaudo. Se manca la possibilità di verificare, manca la possibilità di rifattorizzare in sicurezza, con o senza AI. Un esempio tipico è l'automazione industriale con PLC, dove il codice comanda macchine vere.
Sistemi piccoli e fermi
Un programma da 3.000 righe, usato da due persone e modificato una volta all'anno, non ripaga nemmeno un refactoring a mano. Si mette in sicurezza (copia della macchina, backup, documentazione di base) e si lascia stare.
Quando il problema è altrove
Se l'applicazione è lenta perché il database è disegnato male, o se la logica sta in migliaia di righe di stored procedure, ripulire il C# non cambia nulla. Prima si guarda il modello dei dati. In altri casi il vero ostacolo è la piattaforma: un VB6, un Delphi o un ASP classico non si "rifattorizzano" su se stessi, si portano. Per quei casi vedi migrazione da VB6 a .NET e migrazione da Delphi a .NET. L'AI aiuta anche lì, con le stesse regole.
Quando il team non è pronto
Se nessuno nel team sa leggere con occhio critico il codice generato, l'AI amplifica il problema: più codice, meno comprensione. Prima di introdurla serve almeno una persona in grado di dire "questo non va" e di spiegare perché. Come costruire un gruppo che regge questo carico lo racconto in come costruire un team di sviluppo che scala.
Quali errori si ripetono nei progetti di refactoring con AI?
Gli errori più frequenti sono sei: partire senza test, chiedere cambi troppo grandi, accettare il codice senza leggerlo, mescolare refactoring e correzioni, cominciare dal modulo più brutto e non misurare il risultato.
1. Partire senza test
È l'errore da cui nascono quasi tutti gli altri. Il codice rifattorizzato sembra funzionare, le prove a mano passano, e tre settimane dopo emerge una differenza. A quel punto non si sa quale delle trecento modifiche l'ha introdotta.
2. Chiedere cambi troppo grandi
"Modernizza questo progetto" produce migliaia di righe nuove che nessuno può rivedere. La regola pratica: un cambio che non riesci a rivedere in dieci minuti è troppo grande. Si divide.
3. Accettare senza leggere
Il codice generato ha un aspetto ordinato, e questo abbassa la guardia. Un diff di duecento righe che compila e supera i test sembra un buon diff. Se i test sono pochi, è solo un diff che compila. La lettura resta obbligatoria, per ogni riga.
4. Mescolare refactoring e correzioni
Mentre si rifattorizza si trova un errore nel codice vecchio, e la tentazione è sistemarlo subito. Se lo fai nello stesso commit, i test di caratterizzazione diventano rossi e non sai più se è colpa del refactoring o della correzione. Si annota l'anomalia, si finisce il passo e la si corregge in un commit separato, con un test nuovo.
5. Cominciare dal modulo più brutto
È il più visibile e il più scoraggiante. Si comincia dove si cambia più spesso, perché lì il beneficio arriva subito e la rete di test serve comunque. Il modulo più brutto, se nessuno lo tocca, può restare brutto per altri cinque anni senza costare niente.
6. Non misurare
Se alla fine non sai dire quanto è calato il tempo per fare una modifica, quanti errori in produzione sono diminuiti o quanto codice è coperto dai test, non sai se il progetto è servito. Prima di cominciare si scelgono due o tre numeri e si guardano a fine progetto. Per costruire questa abitudine nel team, il riferimento è la guida per i CTO sul team che scala.
Un'ultima nota sulle persone
Un progetto di refactoring con l'AI cambia il lavoro degli sviluppatori: meno scrittura meccanica, più lettura e giudizio. Chi viene dal vecchio modo di lavorare a volte lo vive come una perdita. Funziona meglio quando si lavora in coppia, una persona che conosce il dominio e una che guida l'assistente, e quando il tempo risparmiato sulla scrittura viene riconosciuto come tempo per i test e la revisione, non come tempo da tagliare dal preventivo.
Come decidere in cinque righe se rifattorizzare il tuo legacy con l'AI?
Se il codice cambia spesso, puoi scrivere test sui punti importanti e c'è chi sa giudicare il risultato, procedi a piccoli passi con l'AI. Se manca anche solo uno di questi tre elementi, comincia da quello.
- Misura quante volte all'anno si modifica il codice e quanti sviluppatori lo conoscono davvero.
- Controlla che il sorgente possa essere condiviso con un servizio esterno, o prepara un ambiente controllato.
- Scrivi i test di caratterizzazione sulle trenta funzioni più importanti, partendo da dati reali.
- Rifattorizza un pezzo alla volta, con richieste piccole, un diff leggibile e una persona che lo rivede.
- Preventiva 45-65 giorni persona ogni 80.000 righe e misura, a fine progetto, tempi di modifica ed errori in produzione.
Con quei cinque numeri, in mezz'ora ti dico quali parti conviene toccare, quali lasciare e quanto costa, senza promettere miracoli. Il lavoro vero comincia dopo, ma almeno comincia con una rete sotto.
Che cosa cambia dopo un refactoring ben fatto?
Cambia che il codice si modifica in ore e non in giorni, che un secondo sviluppatore può lavorarci senza dipendere da una persona sola e che hai una rete di test che protegge ogni cambio futuro, anche quelli fatti con l'AI.
Il primo effetto che i titolari notano è la fiducia: una richiesta di modifica che prima spaventava (nessuno sapeva cosa avrebbe rotto) diventa una voce normale in elenco. Il secondo è la velocità, perché il codice letto in venti minuti invece che in mezza giornata riduce il costo di ogni intervento successivo. Il terzo è la possibilità di fare passi più grandi: dopo il refactoring diventa realistico passare a .NET 10 (vedi migrazione da .NET Framework a .NET 10), sostituire l'accesso ai dati (come in migrazione da Entity Framework 6 a EF Core) o mettere un'API davanti al gestionale.
Il quarto effetto riguarda l'AI stessa. Un codice con i test e con una struttura leggibile è anche un codice su cui l'assistente lavora meglio: capisce di più, sbaglia meno, e i suoi errori si vedono subito. Chi ha fatto il refactoring bene scopre che ogni modifica successiva, con l'AI, costa meno. Chi lo ha saltato, ogni volta che usa l'AI, rischia di più.
Se ti interessa il quadro completo di come affronto questi progetti, dall'inventario al passaggio, lo trovi nella pagina sulla modernizzazione del software legacy. Non è un prodotto da comprare: è un metodo, e comincia sempre da quei cinque numeri.
Il codice legacy ha retto la tua azienda per anni. Rimetterlo in ordine con calma, un pezzo alla volta e con una rete sotto, è il modo giusto di ricambiare il favore. L'intelligenza artificiale rende il lavoro più veloce. La rete lo rende sicuro.
La tua azienda ha bisogno di software su misura o di AI nel team?
Progettiamo e sviluppiamo software su misura, modernizziamo i sistemi vecchi e formiamo i tuoi sviluppatori a lavorare con l'AI. Raccontaci il problema: ricevi una risposta concreta entro un giorno lavorativo.
Domande frequenti
Sì, a una condizione: prima si scrivono i test di caratterizzazione che registrano il comportamento attuale. L'AI accelera comprensione, documentazione, test e trasformazioni meccaniche, ma non sa le regole di business non scritte, quindi ogni modifica passa dai test e dalla revisione di una persona.
Un gestionale C# da circa 80.000 righe senza test costa 27.000-39.000 euro con l'AI usata con metodo, contro 42.000-57.000 euro a mano, con una tariffa di riferimento di 600 euro al giorno. Il risparmio è del 30-35% e non viene dalla revisione, che resta uguale.
Cambia in silenzio arrotondamenti, ordine delle operazioni, formati di data ed effetti collaterali, perché il codice nuovo è più pulito ma diverso. Sono errori che compilano e superano le prove veloci, e si vedono solo con i test di caratterizzazione.
Sono test che registrano cosa fa il codice oggi con ingressi realistici e confrontano le uscite dopo ogni modifica. Non dicono cosa dovrebbe fare il programma: dicono se il comportamento è rimasto uguale.
Dipende dal servizio e dal contratto. Si chiede dove viene elaborato, per quanto tempo è conservato e se viene usato per addestrare i modelli. Chiavi, password e dati personali reali non devono mai uscire.
Quasi sempre conviene rifattorizzare a piccoli passi con una rete di test. Riscrivere lo stesso gestionale costa 180.000-260.000 euro e richiede almeno nove mesi senza nuove funzioni, anche con l'AI.
Lascia i tuoi dati nel form qui sotto